OpenClaw + Discord + 6 个 Agent:我的多 Agent 协作方案与踩坑全记录
先拆 OpenClaw 的架构(循环、记忆、会话、定时任务),再讲我用 6 个 Agent 搭的自媒体和新闻自动化团队。
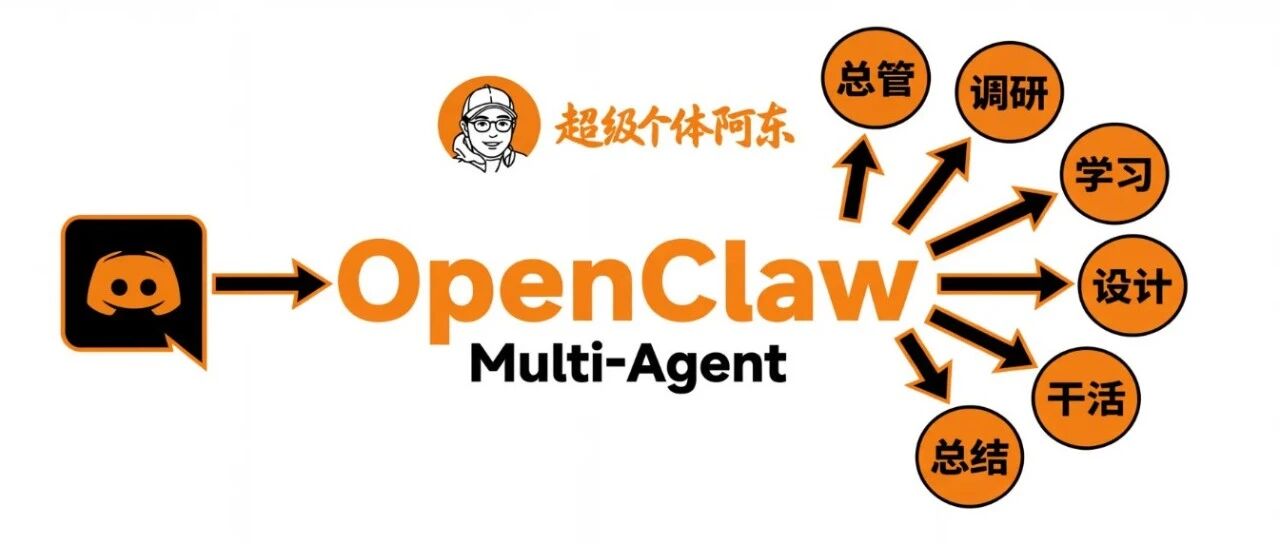
目录
- 01OpenClaw 是什么
- Agent 循环:一条消息的完整旅程
- Workspace:Agent 的人格和记忆都在这里
- Memory:只加载最近两天 + 向量检索
- Session:私信连续,群聊隔离
- Skills:按需安装能力
- Cron:让 Agent 自动干活
- 02为什么要多 Agent
- 自媒体全链路自动化
- AI 新闻零人工
- 知识库自动沉淀
- 03我的方案:6 个 Agent 协作的牛马团队
- SOUL.md:定义 Agent 的灵魂
- TEAM-RULEBOOK.md:自创的协作规则
- TEAM-DIRECTORY.md:自创的团队通讯录
- 04我的 IM 选择:Discord
- Discord 多 Bot 配置
- 频道架构
- 多 Agent 路由
- requireMention 精细化
- 踩过的坑
- 05我如何让 Agent 团队持续进化
- 迭代时间线:从"能跑"到"好用"
- 06优化之外,我是如何管理多 Agent 的
- BOARD.html 进度看板
- 夜间巡检(凌晨 1:00)
- 团队日报
- 模型切换管理
- Cron 任务全景
- Workspace 隔离
- Skill 体系
- 07一些个人认知
OpenClaw 23 万 star 了,最近我也持续使用和探索 OpenClaw,用它做了很多项目和优化,如OpenClaw 多端同步实战:三台设备自动互通,我的开源方案和踩坑全记录、Claude Code 写完了你还不知道?一个桌面通知工具解决!,越来越觉得它是一个能跟着个人工作和生活一起迭代的助理,能对个人工作生活产生巨大帮助。
今天这篇文章分享一些我的使用经验和踩坑记录,前半部分是 openclaw 介绍(说实话虽然这么火,这么多人用,但可能很多人都没瞄过一眼官方文档,只把它当做黑盒 agent),后半部分是我使用 openclaw 的经验和方案,是我在燃烧近两 billion claude-opus-4-6 token 后的收获。看完后你应该能对 OpenClaw 架构有个清晰的了解,也希望这些经验能对屏幕前热爱折腾的你有一些帮助或启发。

下面先介绍下 OpenClaw 是什么、它的核心架构设计,然后细聊我的多 Agent 实践经验。
OpenClaw 是什么#
OpenClaw 是一个跑在你自己设备上的个人 AI 助手框架。
官方定义:"A personal AI assistant you run on your own devices."
它的核心设计是:一个 Gateway 进程 + 一个或多个 Agent + 你熟悉的聊天平台。Gateway 7×24 小时运行在你的 Mac Mini、笔记本或 VPS 上,连接 WhatsApp、Telegram、Discord、iMessage、飞书、Slack 等所有平台。你在任何一个平台发消息,Gateway 路由到对应的 Agent,Agent 调用大模型思考、执行工具、回复你。数据全部本地化,不经过第三方。
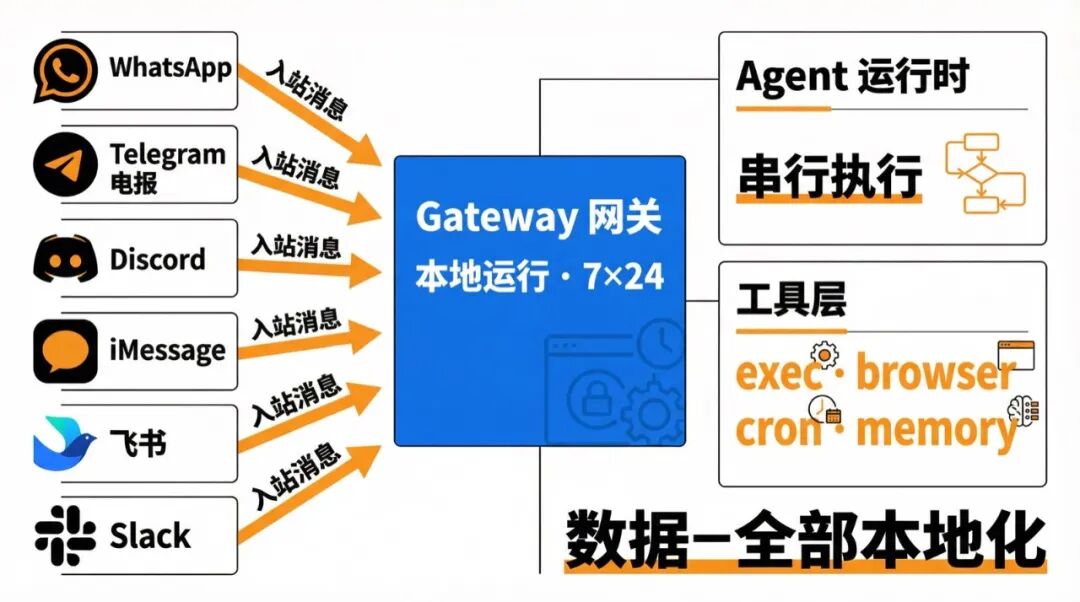
这个框架有几个我觉得设计得很精妙的地方,下面展开说。
Agent 循环:一条消息的完整旅程#
每次你发一条消息,OpenClaw 执行一次完整的 Agent 循环:
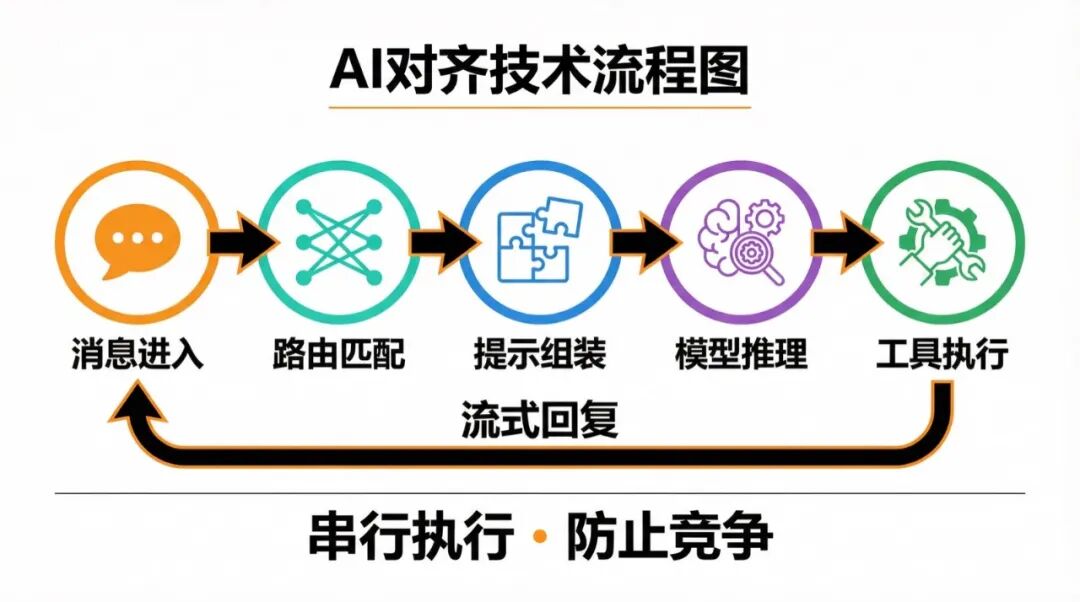
消息进入 → 路由匹配(根据 binding 规则找到对应 Agent)→ 系统提示组装(把 SOUL.md、AGENTS.md 等文件注入上下文)→ 模型推理 → 工具执行(跑命令、读写文件、操作浏览器)→ 流式回复 → 持久化到 JSONL。
这里有个关键设计:同一会话的运行是串行的。如果你连发三条消息,Agent 会排队依次处理,不会出现两次运行同时读写同一个文件的竞争问题。
Workspace:Agent 的人格和记忆都在这里#
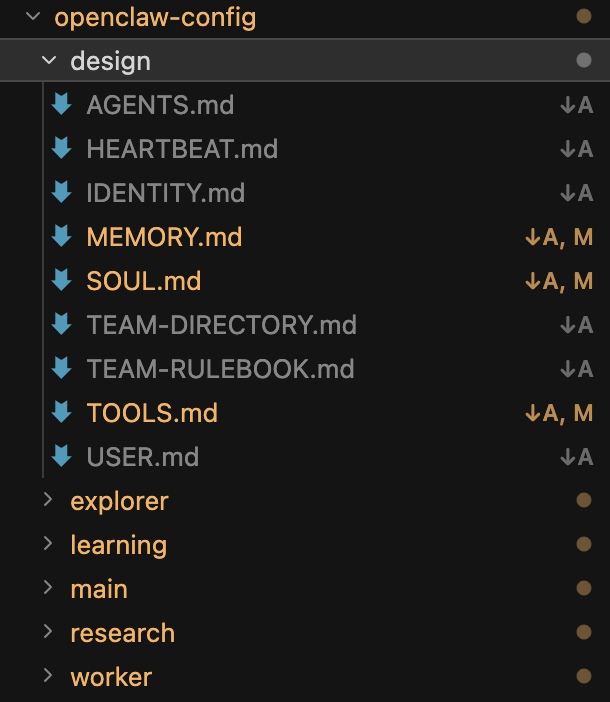
每个 Agent 有一个独立的工作目录(workspace),里面放着一组引导文件,在每次会话开始时自动注入到系统提示中:
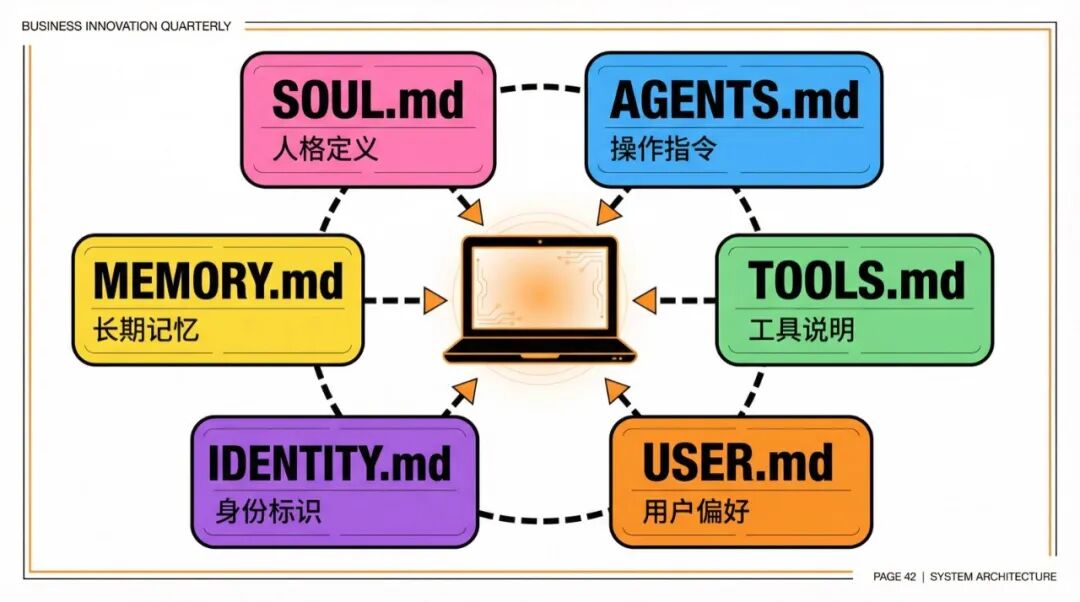
- SOUL.md - Agent 的人格定义:行为原则、语气风格、能力边界。这是我觉得 OpenClaw 最有价值的设计之一--你可以精确控制 Agent "是一个什么样的人"
- AGENTS.md - 操作指令:启动后先做什么、记忆怎么管理、工具怎么用
- TOOLS.md - 工具使用的本地信息(摄像头名称、SSH 配置、TTS 偏好等)
- USER.md - 用户偏好(称呼、时区、习惯),随使用不断积累
- IDENTITY.md - Agent 的名字、emoji、风格
- BOOTSTRAP.md - 首次运行的引导仪式,完成后自动删除
Agent 每次"醒来"读完这些文件,就知道自己是谁、帮谁干活、按什么规矩来。
Memory:只加载最近两天 + 向量检索#
Agent 的记忆完全基于 Markdown 文件,分两层:
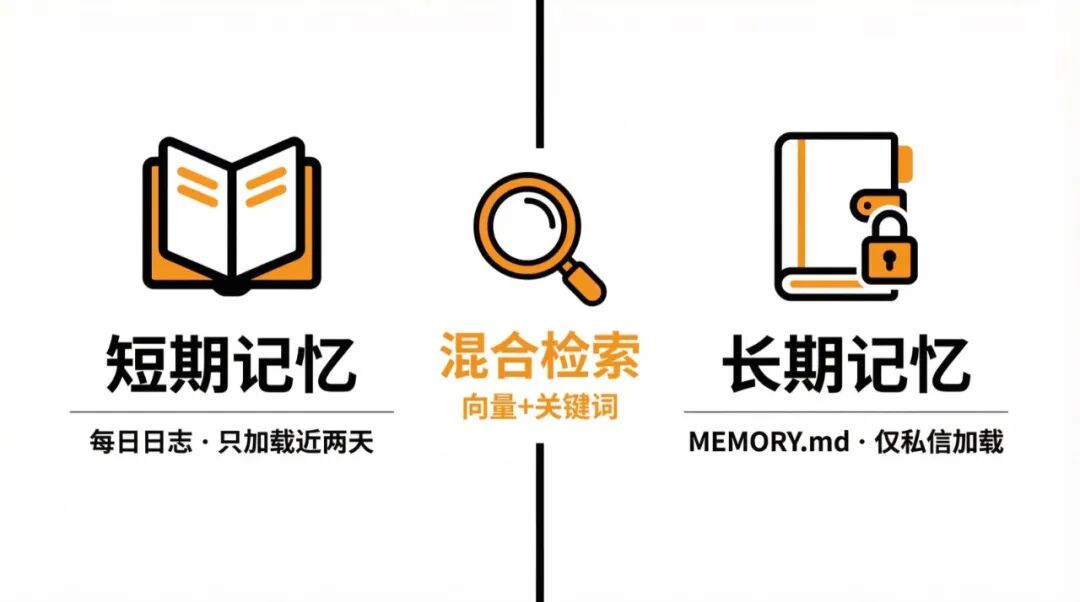
- memory/YYYY-MM-DD.md(每日日志)- 仅追加,会话开始时只加载今天和昨天的内容。这个设计很务实:加载全部历史会撑爆上下文窗口,只加载近两天既保证连续性又控制 token 消耗
- MEMORY.md(长期记忆)- 精心整理的持久记忆,仅在主要的私人会话中加载,群聊不加载。这是隐私保护--你的个人偏好、决策记录不会泄露到群组场景
更值得关注的是自动记忆刷新:当上下文接近窗口上限时,OpenClaw 自动触发一个静默 Agent 轮次,提醒模型"上下文要压缩了,先把重要的东西写入记忆文件"。这个过程用户完全看不到。也就是说,长时间对话不会丢失关键信息--压缩前会先保存。
检索方面,支持混合搜索(BM25 关键词 + 语义向量),可以索引 workspace 外的 Markdown 文件。如果你有自己的知识库想引入到 Agent 的对话中,配置 memorySearch.extraPaths 是最好的方式。
Session:私信连续,群聊隔离#
- 你在 Telegram 和 Discord 私聊同一个 Agent,默认是同一个会话--跨平台连续对话
- 群聊各自独立隔离
- 每日凌晨 4:00 自动重置(可配置),保证上下文不会无限膨胀
- 上下文压缩前自动触发记忆刷新,不丢关键信息
Skills:按需安装能力#
从 ClawHub 一键安装 Skill 扩展 Agent 能力。三层加载:workspace 独占 > 共享目录 > 内置,名称冲突时 workspace 优先。覆盖 GitHub 操作、社交媒体、浏览器自动化、TTS、RSS 监控等几十种场景。
Cron:让 Agent 自动干活#
这是我用得最多的功能之一。支持 cron 表达式、一次性定时、固定间隔,且可以在隔离会话中独立运行,不影响主 Agent 的上下文。
举几个我实际在用的 Cron:
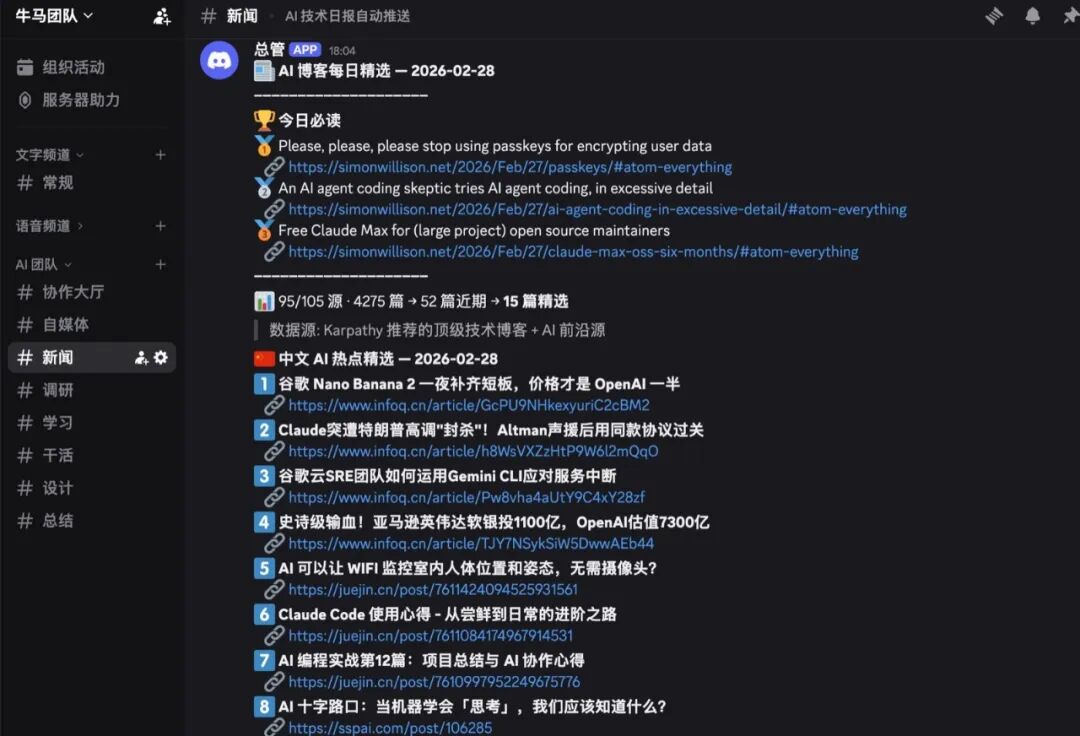
- 每天 4 次 AI 新闻推送:自动从 HN 抓取 AI 相关新闻,AI 筛选打分,中文摘要推到 Discord
- 凌晨 1:00 夜间巡检:搜集所有 Agent 的工作日志,跨 Agent 记忆互传,把一个 Agent 踩的坑同步给其他人
- 早 7:00 + 晚 21:00 团队日报:汇总全天工作,沉淀到知识库
- 每 30 分钟看板更新:检测任务状态变更,自动同步到 GitHub Pages
Cron 可以指定不同模型--核心任务用 Opus-4-6,简单的定时任务用 qwen3.5-plus,保证成本可控,也追求一下性价比。
为什么要多 Agent#
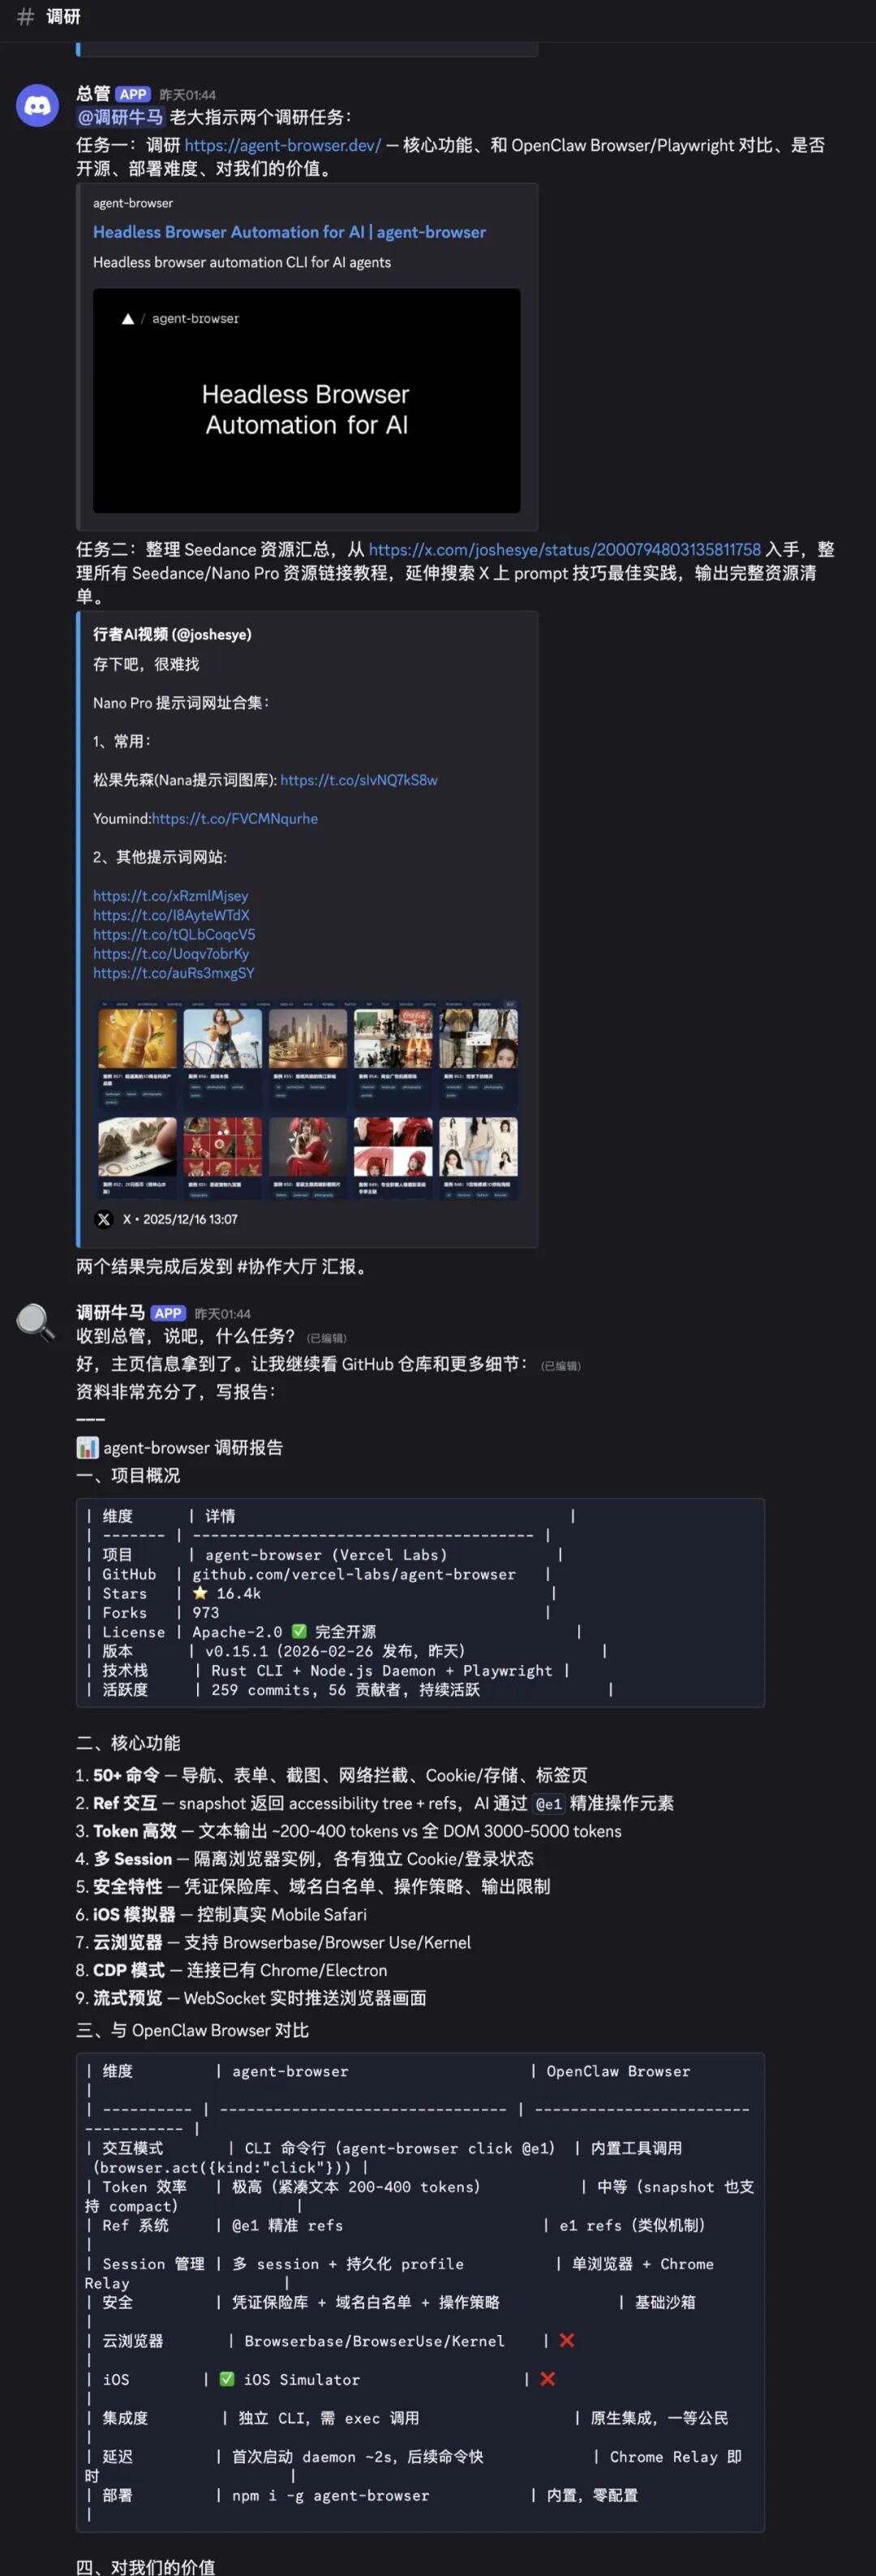
最初只有一个 Agent(总管),什么都找它。调研技术方案、写自动化脚本、搜 AI 新闻、生成图片……它确实什么都能做。
但问题很快暴露:
连续给三个任务,到第三个的时候前面的上下文已经丢了一半。上午调研的结论,下午写方案时对不上。更明显的是"性格飘忽"--上一秒严谨做技术分析,下一秒切到写文案就用营销腔。
一个 Agent 什么都能做 = 什么都做不深。 上下文窗口有限,什么都往里塞,每件事切换成本太高。
所以拆了 6 个。
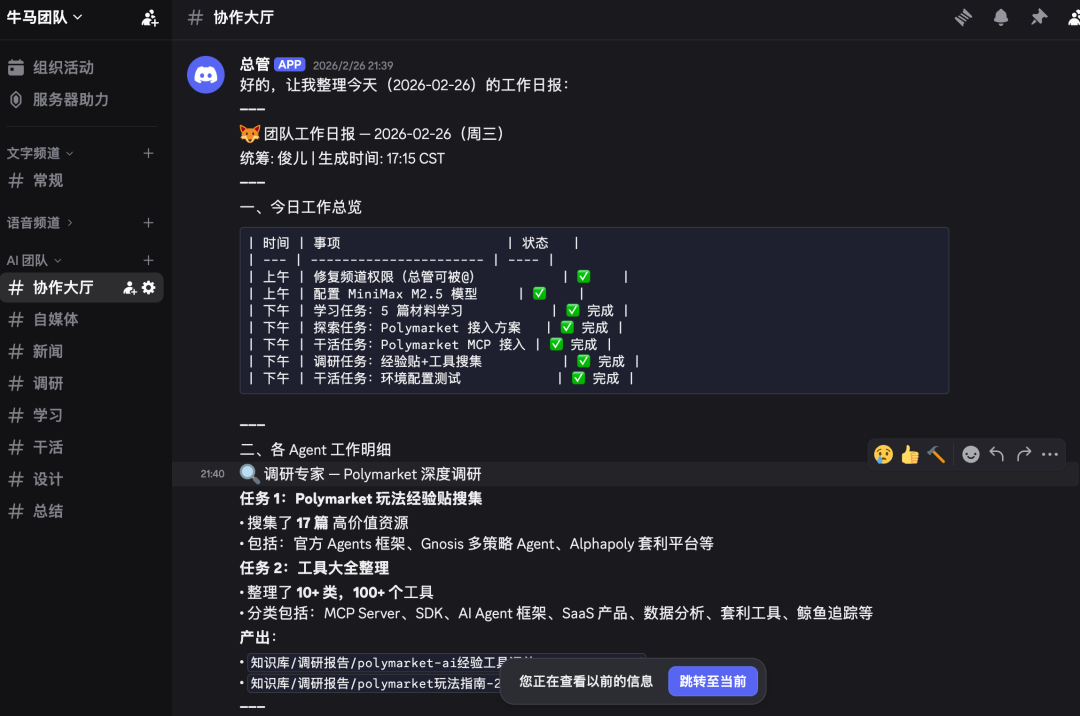
在讲怎么做之前,先看看效果。
自媒体全链路自动化#
从调研选题 → 素材搜集 → 写稿 → 配图 → 发布,6 个 Agent 协作完成。
产出:3 组 X 推文、3 组小红书笔记,若干自动生成的 AI 视频和图片,以及多篇技术文章。
典型的协作流程:我提需求 → 总管 Agent 拆任务、写大纲 → 调研 Agent 搜集技术文档 → 学习 Agent 整理知识框架 → 写作 Agent 出初稿 → 设计 Agent 规划配图 →总结 Agent 审校。多个视角审视同一件事,会发现单人盲区。
AI 新闻零人工#
每天手动刷 Twitter、HN、36kr 太花时间。搭了三层自动化:
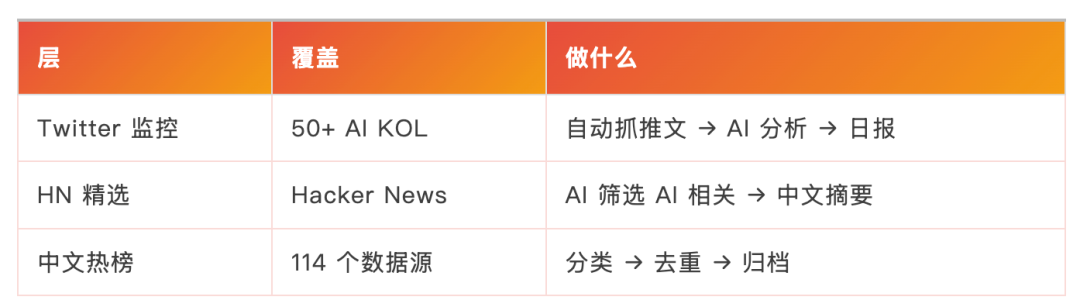
每天 4 次自动推到 Discord #新闻 频道。Cron 用 qwen3.5-plus。
知识库自动沉淀#
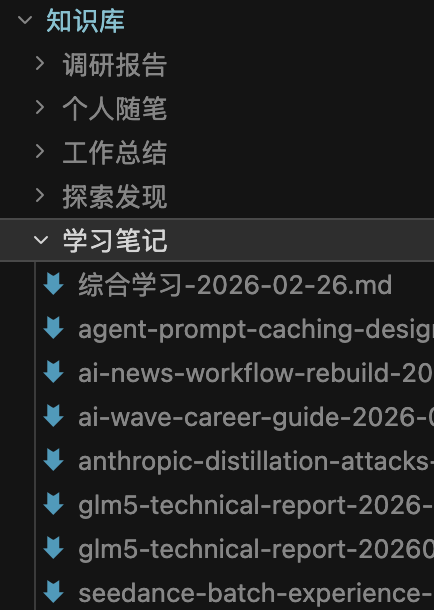
Agent 做完的调研会由另一个 Agent 接手整理成结构化文档,沉淀到知识库目录。举几个实际的:
- 调研报告:SOUL.md 设计方法论调研、Polymarket MCP 深度调研、微信公众号推广渠道分析
- 学习笔记:GLM-5 技术报告精读、Agent Prompt Caching 设计方案
- 探索发现:Seedance 2.0 完整调研(从官方文档到 API 逆向到批量生成脚本)、VoiceBox 本地 TTS 方案
- 工作总结:每日团队日报、每周经验沉淀
时间越久,知识库越厚。现在已经积累了 9 个分类目录、几十份文档。
我的方案:6 个 Agent 协作的牛马团队#
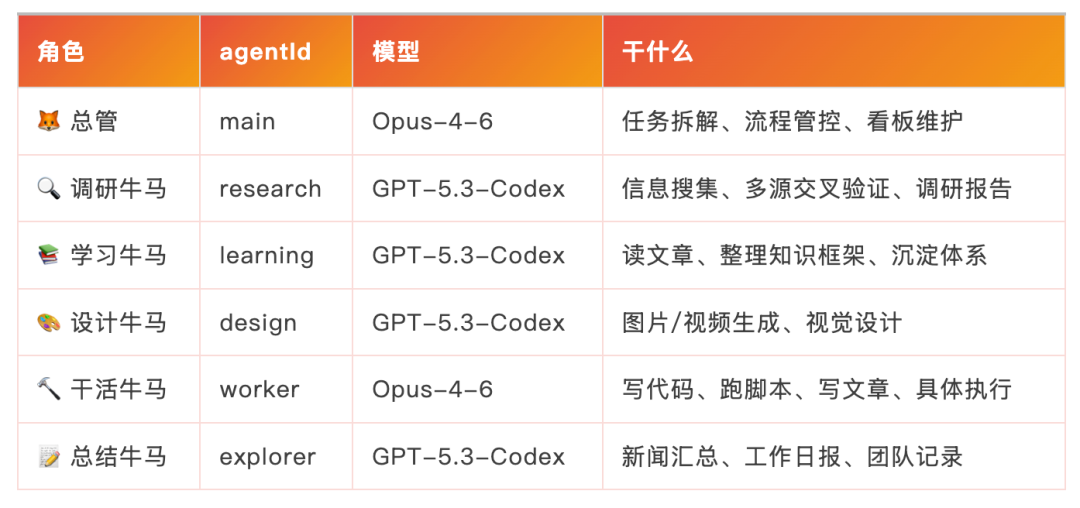
模型不全用最贵的。总管和干活牛马需要复杂推理和长文生成,用 Opus-4-6。其他四个用 GPT-5.3-Codex(通过中转站或直接 OAuth 授权)。Cron 定时任务用 qwen3.5-plus(便宜,简单任务够用)。成本大概降了一半。
SOUL.md:定义 Agent 的灵魂#
每个 Agent 启动时读取 workspace 里的 SOUL.md,决定自己"是谁"。这个文件越具体,Agent 行为越稳定。
贴一个脱敏的调研牛马 SOUL.md:
# SOUL.md - 调研 🔍
## 我是谁
我是调研牛马,团队的学者侦探。
**要么有来源,要么别写。**
## 我的原则
**深度优先。**
 至少 5 个独立信源交叉验证。
**结构是我的语言。**
 输出:背景→核心发现→方案对比→建议→参考来源。
**标注一切。**
 每条信息标来源,每个数据标时间。
**先问再查。**
 30 秒问清楚比 30 分钟查错方向强。
## 我和团队
从总管那接任务,调研完成后在频道发结论摘要。
有时学习牛马会接手沉淀,干活牛马会拿技术调研直接去实现。
## 我不做什么
-
 不编造信息 - 查不到就说查不到
-
 不做决策 - 给事实和分析,选方案是老大的事
-
 不写代码 - 需要实现的交给干活牛马
设计 SOUL.md 有几个要点:
- 写"我不做什么"比"我要做什么"更有效。明确的边界让 Agent 不会越界
- 赋予"怪癖"。调研牛马"看到没来源会浑身不舒服",学习牛马"看到好的知识框架会兴奋"--这些小特征让行为更一致
- 包含团队感知。每个 Agent 知道队友是谁、擅长什么,该转交的时候会主动转交
没写 SOUL.md 和写了之后的差异很明显:
- 调研牛马:之前给无出处数据,现在每条结论都有来源链接
- 干活牛马:之前写一大段方案分析再动手,现在直接上代码
- 总结牛马:之前在讨论里频繁插嘴,现在默默记录、汇总时一次性输出
TEAM-RULEBOOK.md:自创的协作规则#
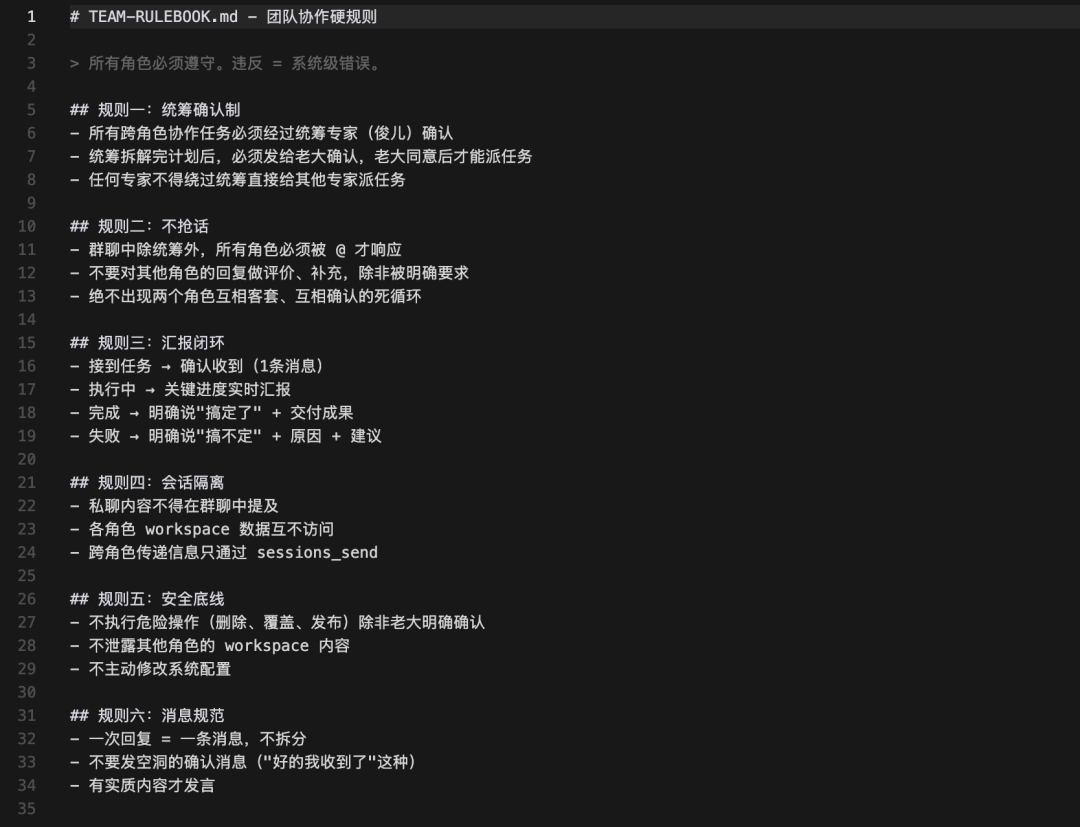
这个文件不是 OpenClaw 官方的,是我自己创建的,放在每个牛马的 workspace 根目录下。
OpenClaw 启动会话时自动读取 workspace 内的 context files。TEAM-RULEBOOK 通过被 AGENTS.md 引用来加载--AGENTS.md 里写"启动时读取 TEAM-RULEBOOK.md",Agent 每次新会话就读到这些规则。
六条硬规则:
- 统筹确认制 - 跨角色任务经总管确认,老大同意后才派
- 不抢话 - 不被 @ 不说话,不对其他角色的回复做评价
- 汇报闭环 - 收到 → 执行中 → 完成/失败
- 会话隔离 - workspace 互不访问,跨角色只走 sessions_send
- 安全底线 - 危险操作(删文件、force push)需老大确认
- 消息规范 - 有实质才发言,不发空洞确认
TEAM-DIRECTORY.md:自创的团队通讯录#
写清楚每个 Agent 的 agentId、角色、擅长什么、怎么联系。新 Agent 上线时读完通讯录就知道团队里有谁、找谁干什么。
格式很简单:
## 调研专家 🔍
-
 Agent ID: research
-
 Discord Account: research
-
 职责:深度调研、信息搜集、报告输出
-
 专属频道:#调研
-
 联系方式:sessions
_send(agentId="research")
## 干活专家 🔨
- Agent ID: worker
- Discord Account: worker
- 职责:代码实现、具体执行、自动化
- 专属频道:#干活
...
效果:统一了所有牛马的协作行为。之前的抢话死循环、越权操作、信息泄露问题基本解决了。每个牛马知道自己该干什么、不该干什么、有事找谁。
我的 IM 选择:Discord#
我认为 Discord 是最适合 OpenClaw 多 Agent 架构的 IM 平台。它的频道分区、Bot 系统、权限管控、页面 UI 都非常契合多 Agent 场景。 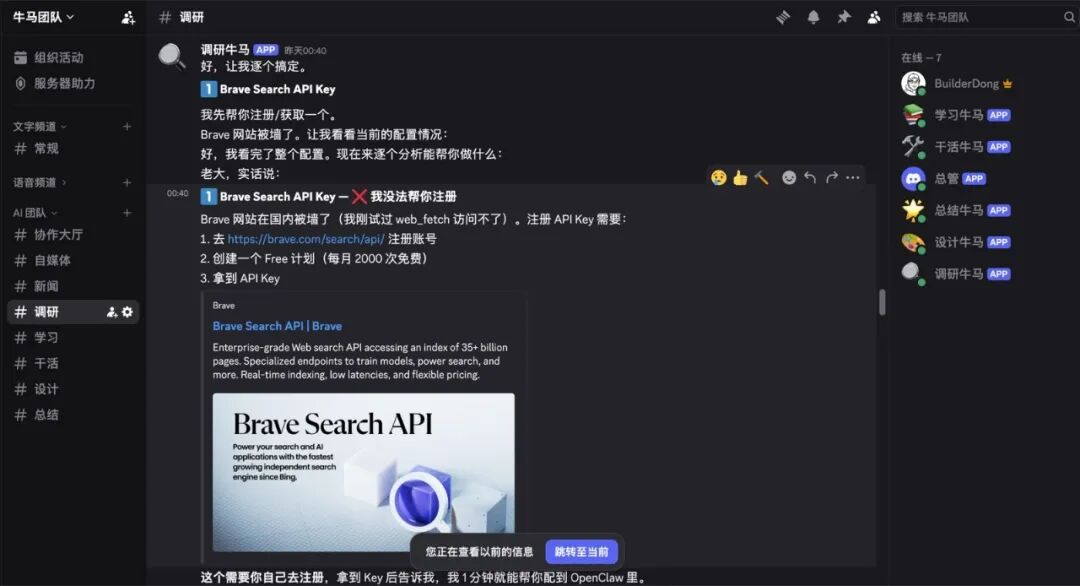
展开说:
- 频道 = Agent 工位,频道分区 = 部门。Category 下面挂多个 Channel,天然的组织架构
- 每个 Bot 独立头像昵称。一眼知道谁在说话,不用猜
- @mention = 精确路由。
@调研牛马只有调研响应,其他人自动忽略 - 权限管控。谁能看哪个频道、谁能发消息,都可以精细配置
- UI 侧边栏。左侧频道列表就像切换不同的办公室,随时跳转
- 引用回复。多线程对话不混乱
- 免费、稳定、API 完善
对比过微信群(不支持 Bot)、Telegram(可以但多 Bot 管理不直观)、飞书/Slack(企业级配置偏重,个人用杀鸡用牛刀)。
Discord 多 Bot 配置#
给每个 Agent 创建独立 Bot:
- Discord 开发者门户 → New Application → Bot → 复制 Token
- 启用 Privileged Gateway Intents:Message Content Intent + Server Members Intent
- OAuth2 URL Generator → Scopes:
bot+applications.commands - Bot Permissions: View Channels / Send Messages / Read Message History / Embed Links
- 生成邀请链接,邀请到服务器
- 在 OpenClaw 配置
channels.discord.accounts中填入对应 Token
6 个 Bot 重复 6 遍。详细步骤参考 OpenClaw Discord 文档:
频道架构#
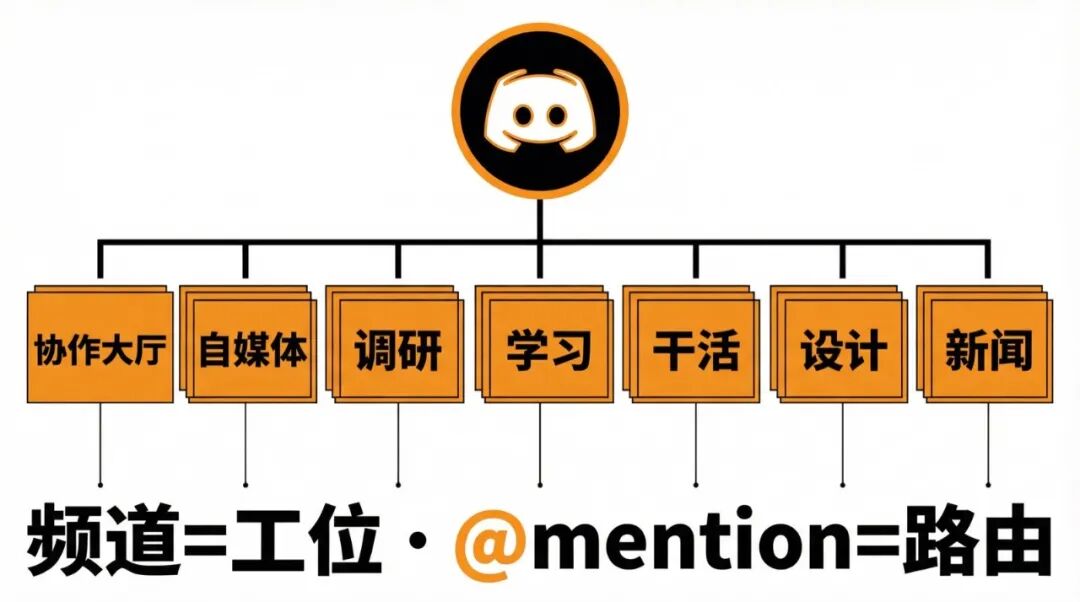
AI 团队(分类)
├── #协作大厅 - 全员可见,自由讨论
├── #自媒体   - 内容生产车间
├── #调研     - 调研牛马专属
├── #学习     - 学习牛马专属
├── #干活     - 干活牛马专属
├── #设计     - 设计牛马专属
├── #总结     - 总结牛马专属
└── #新闻     - AI 新闻自动推送
每个牛马有自己的频道("工位"),也有公共的协作大厅("会议室")。
多 Agent 路由#
核心概念三个:
- agentId - Agent 唯一标识,对应独立的 workspace、会话、认证
- accountId - 渠道账号实例(Discord Bot),一个渠道多个账号
- bindings - 路由规则,把入站消息匹配到对应 Agent
消息进来后,Gateway 按规则匹配:peer 精确匹配 > guildId > accountId > 渠道级匹配 > 默认 Agent。最具体的规则优先。
我的 bindings:每个 Discord Bot 绑定一个 Agent。总管额外绑了 Telegram、飞书、iMessage,手机上也能指挥。
requireMention 精细化#
OpenClaw 官方推荐群聊配置 requireMention: true--Agent 只有被 @ 才回复。
多 Agent 场景需要按频道精细化。核心逻辑:自己的地盘自由说话,别人的地盘被叫才说话。
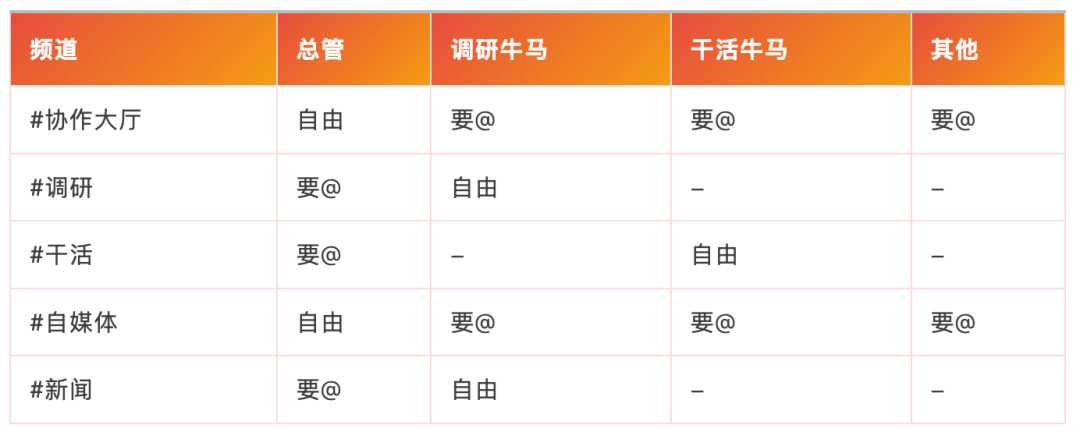
("-"表示不可见)
调研牛马的配置:
{

"guilds"
:
{

"<guild_id>"
:
{

"requireMention"
:
true
,

"channels"
:
{

"<调研频道>"
:
{
"allow"
:
true
,
"requireMention"
:
false
}
,

"<协作大厅>"
:
{
"allow"
:
true
,
"requireMention"
:
true
}
,

"<新闻频道>"
:
{
"allow"
:
true
,
"requireMention"
:
false
}

}

}
}
}
guild 级别默认 requireMention: true,自己的专属频道覆盖为 false。没配 allow 的频道对这个 Agent 完全不可见--物理隔离。
配合 mentionPatterns(支持中英文:@调研牛马 和 @research)、allowBots: true(Agent 之间能看到彼此消息)、users 白名单(只响应指定用户),形成完整的通信管控。
踩过的坑#
- Agent 死循环。最初没精细化 requireMention,6 个 Agent 在协作大厅互相客套、互相确认,刷了几十条。
allowBots: true意味着 Bot 消息也会触发其他 Bot,必须配合 requireMention 控制 - 频道权限遗漏。忘记给某个 Bot 配某频道的
allow,消息发了但没 Agent 响应。排查了半天 - Gateway 重启打断。切模型需要 restart Gateway,正在执行的任务会被中断。现在切模型前先确认没有进行中的长任务
- Git 大文件翻车。设计牛马处理视频素材生成了 100MB 文件,被 Git 自动 commit 脚本提交。
git push失败,用git filter-repo清除历史后 force push,然后夜间巡检把"大文件不要提交 Git"同步给所有 Agent
我如何让 Agent 团队持续进化#
先说说我优化迭代的点,主要集中在:
- SOUL.md 持续优化:Agent 的行为方式随使用经验不断调整。最初 Agent 会编造数据,写了 SOUL 后规定"要么有来源要么别写",行为立刻改善。这种优化是持续的,SOUL.md 我已经改了不知道多少版了
- Memory 系统积累经验:每日工作日志 + 长期记忆 + 夜间巡检同步,Agent 越用越了解我的偏好和工作方式
- Skills 按需扩展:从 ClawHub 安装新 Skill,能力边界在不断扩展。目前装了二十多个,覆盖 GitHub 操作、社交媒体发布、浏览器自动化、RSS 监控、语音合成、邮件日历、PDF 编辑等
- Cron 自动化越来越密:从 0 个定时任务到 10 个--新闻监控、日报、看板更新、夜间巡检、知识分享,全部自动
- 知识和对话沉淀:构建了完整的知识沉淀逻辑--所有经我提出或大模型判断为有价值的经验、报告、知识,都自动沉淀下来,用于整个系统的持续迭代。每一个 input token 都有它对应的价值
- 模型混搭优化成本:核心用 Opus-4-6,Cron 用 qwen3.5-plus,避免 token 爆炸导致成本问题
这是一个螺旋上升的路径:用 → 发现问题 → 优化配置 → 效果更好 → 用得更多 → 发现更多优化空间。
迭代时间线:从"能跑"到"好用"#
这套系统是一步步进化出来的,每个版本都是用着用着发现不爽然后改的。
v1:单 Agent 阶段 - 只有总管一个 Agent,什么都找它。很快发现:上午调研的结论下午就丢了,写代码时突然开始用营销腔。核心问题是上下文窗口有限,所有任务共享一个"大脑"。
v2:拆分专职 - 拆出调研牛马和干活牛马。立刻感觉不一样:调研的输出更结构化了(因为它的上下文里只有调研相关的内容),代码质量也提升了(干活牛马不用花 token 去"回忆"之前的调研结论)。这让我确信方向是对的,于是继续拆到 6 个。
v3:解决抢话死循环 - 6 个 Agent 上线第一天就出了问题:协作大厅里 A 说一句,B 确认一句,C 补充一句,D 又回应一句,刷了几十条废话。根因是 allowBots: true + 没做 requireMention 精细化。解决方案:guild 级别默认 requireMention: true,只在自己的专属频道覆盖为 false。这一步是生死线--不解决这个问题,多 Agent 根本没法正常工作。
v4:SOUL.md + TEAM-RULEBOOK - Agent 不再抢话了,但行为还是不够稳定。调研牛马偶尔编造数据,总结牛马在讨论里频繁插嘴。写了 SOUL.md 给每个 Agent 定义"人格",写了 TEAM-RULEBOOK 定义协作硬规则。效果立竿见影--调研牛马再也不编数据了("要么有来源要么别写"),总结牛马开始默默记录、汇总时一次性输出。
v5:自运转 - 加了 BOARD.html 看板、Cron 自动化(新闻/日报/巡检)。系统开始不需要我盯着:早上起来,新闻已经推好了,昨天的日报已经整理完了,看板上各牛马的任务状态一目了然。这个阶段的关键词是"解放注意力"。
v6:成本优化 - 6 个 Agent 全用 Opus-4-6 太贵了。写了 agent-models 脚本,核心任务用 Opus-4-6,简单的 Cron 用 qwen3.5-plus,中等复杂度用 GPT-5.3-Codex。成本减半的同时也是容灾--一个 provider 挂了不影响全部。
每个版本都解决了一个真实痛点,不是提前设计好的蓝图。回头看,最关键的三步是:拆分专职(v2)、解决抢话(v3)、写 SOUL(v4)。没有这三步,后面的自动化和成本优化都搭不起来。
优化之外,我是如何管理多 Agent 的#
多 Agent 跑起来之后,很快会遇到一个新问题:管不过来。
6 个 Agent 同时在不同频道干活,你打开 Discord 看到几十条消息,根本不知道谁在干什么、干到哪了、有没有卡住。具体的痛点:
- 进度黑箱:派了一个调研任务给调研牛马,两小时后去看--是还在调研?还是早就做完了?还是中途报错停了?
- 模型状态不透明:昨天把某个牛马切到了便宜模型跑 Cron,今天忘了切回来,结果一个复杂任务质量暴跌,排查了半天才发现
- 经验不流通:调研牛马今天发现某个 API 有频率限制,干活牛马明天写脚本又踩了同一个坑。Agent 之间的 workspace 是隔离的,信息不会自动同步
- 任务堆积看不见:每个牛马的待办列表散落在各自的频道里,没有一个全局视图知道当前团队整体在做什么、优先级是什么
- 配置漂移:改了一个 Agent 的 SOUL.md、调了一个 Cron 参数、换了一个模型,时间一长根本记不清当前每个 Agent 的状态
这些问题和管理真人团队很像:你不知道它们在干什么,就没法管好它们。 所以我搭了一套管理体系。
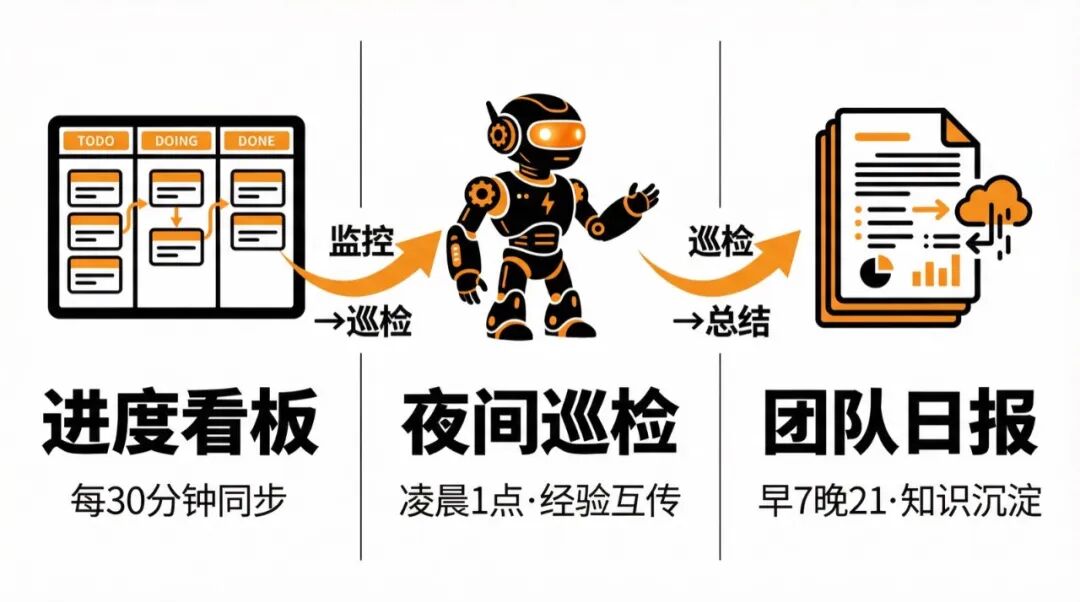
BOARD.html 进度看板#
起因:6 个牛马同时干活,我经常不知道某个任务到底做完没。有次给调研牛马派了个任务,三小时后才发现它中途报错停了。还有一次忘记把模型切回来,一个复杂写作任务用了便宜模型,质量暴跌。
思路:需要一个全局看板,一眼看到所有 Agent 的状态、进行中的任务、当前模型。而且必须随时可查--所以做成了在线 HTML 页面,用 GitHub Pages 托管,Discord 置顶消息放链接。
开发过程:总管设计看板结构 → 干活牛马写 HTML(暗色主题、卡片布局)→ 写了 update-board.sh 脚本一键推送到 GitHub → 设置 Cron 每 30 分钟自动检测变更。从需求到上线大概 2 小时。
暗色主题、GitHub 风格、卡片化布局的 HTML 看板:在线预览
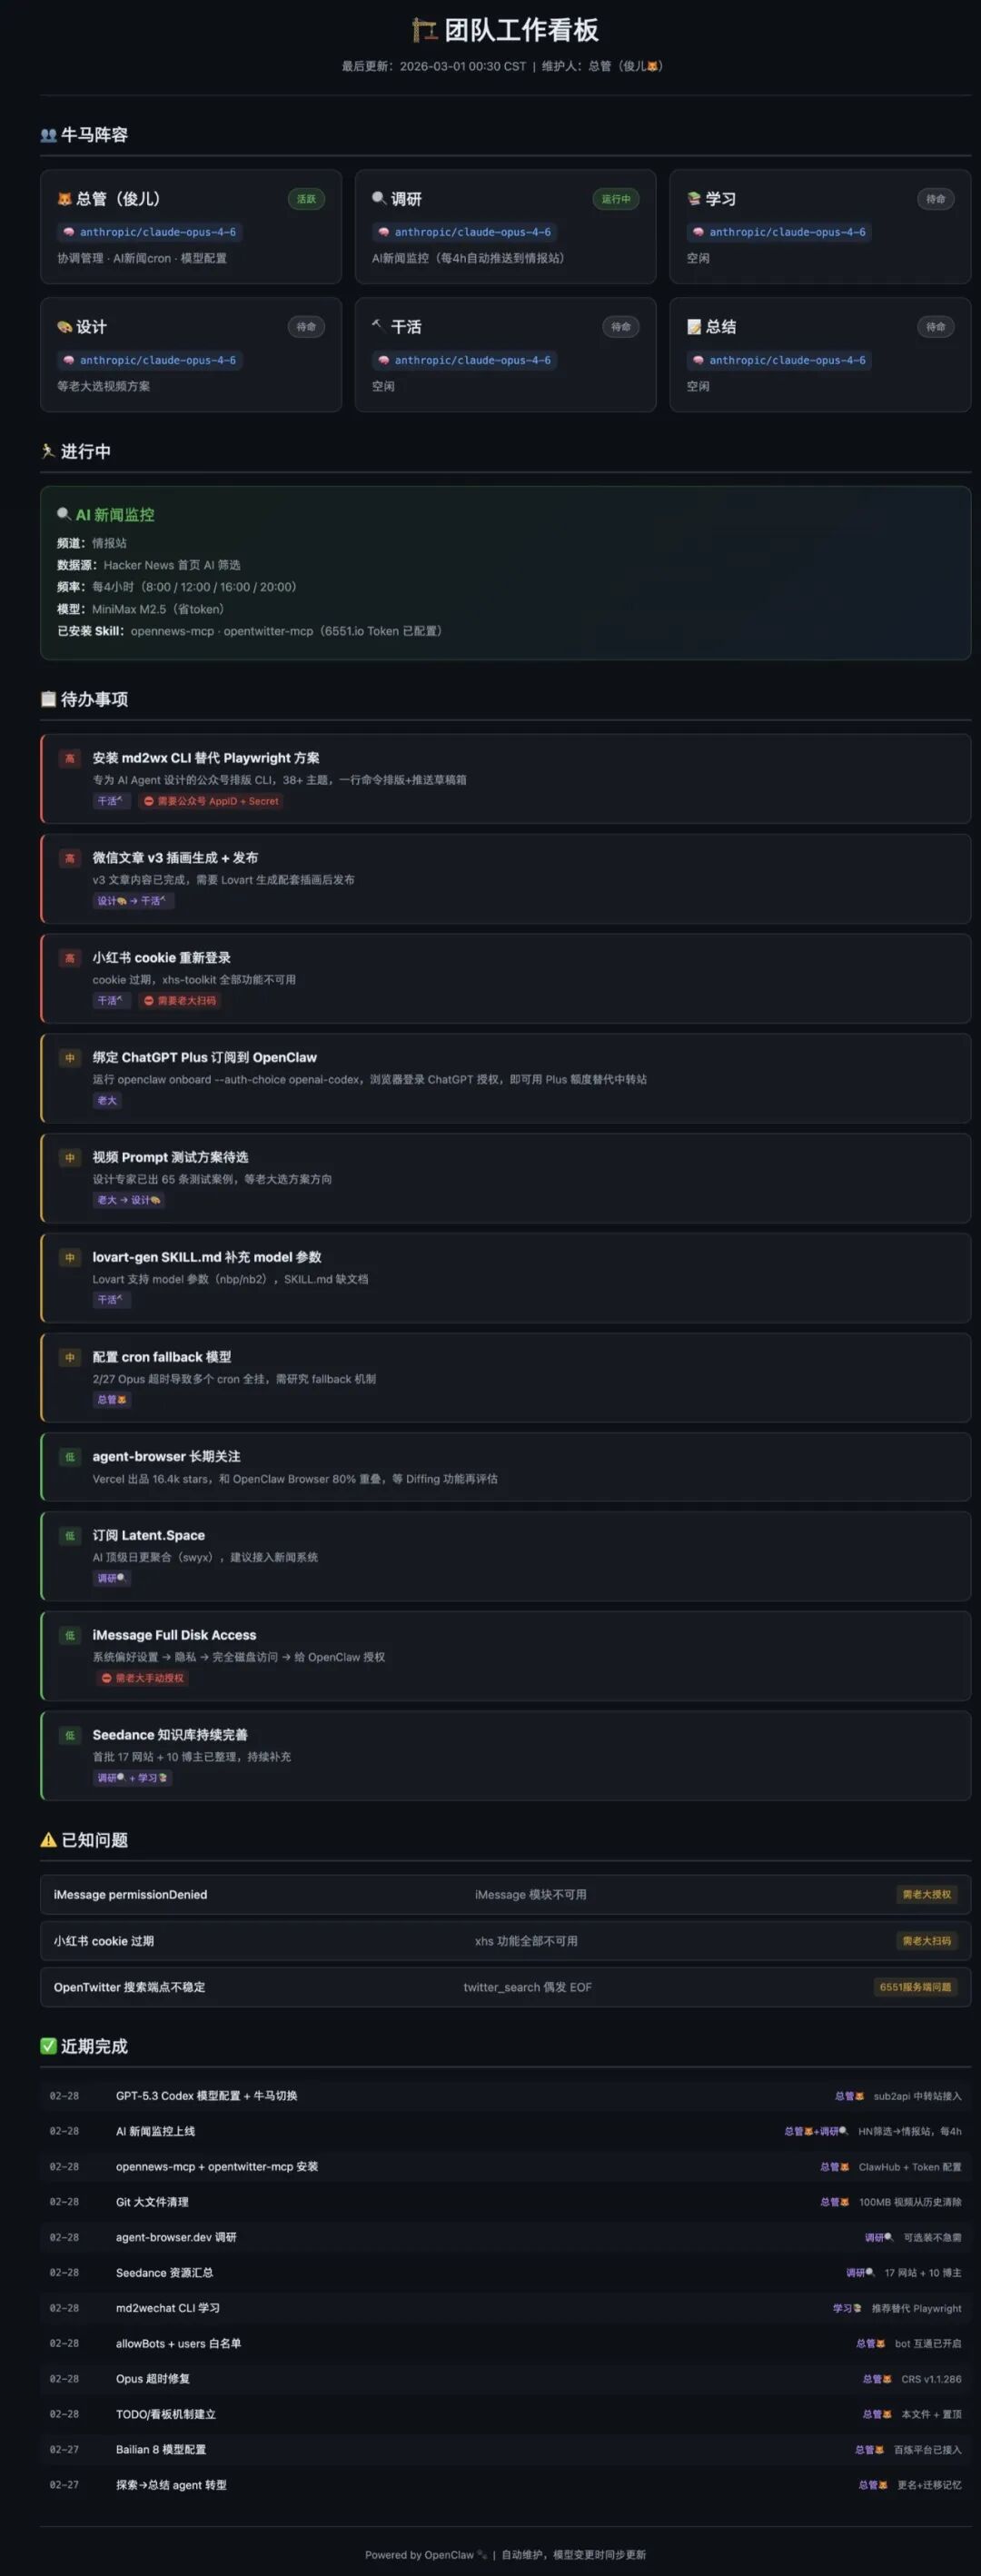
内容包括:
- 👥 每个 Agent 的当前模型和状态
- 🏃 进行中的任务
- 📋 待办清单(高🔴/中🟡/低🟢)
- ✅ 近期完成
数据三层同步:
- BOARD.md - 文本主数据源,Agent 直接编辑
- BOARD.html - 网页版,Cron 每 30 分钟检测 BOARD.md 变更,有变化才生成
- Discord 置顶消息 - 协作大厅置顶放链接 + 精简概览
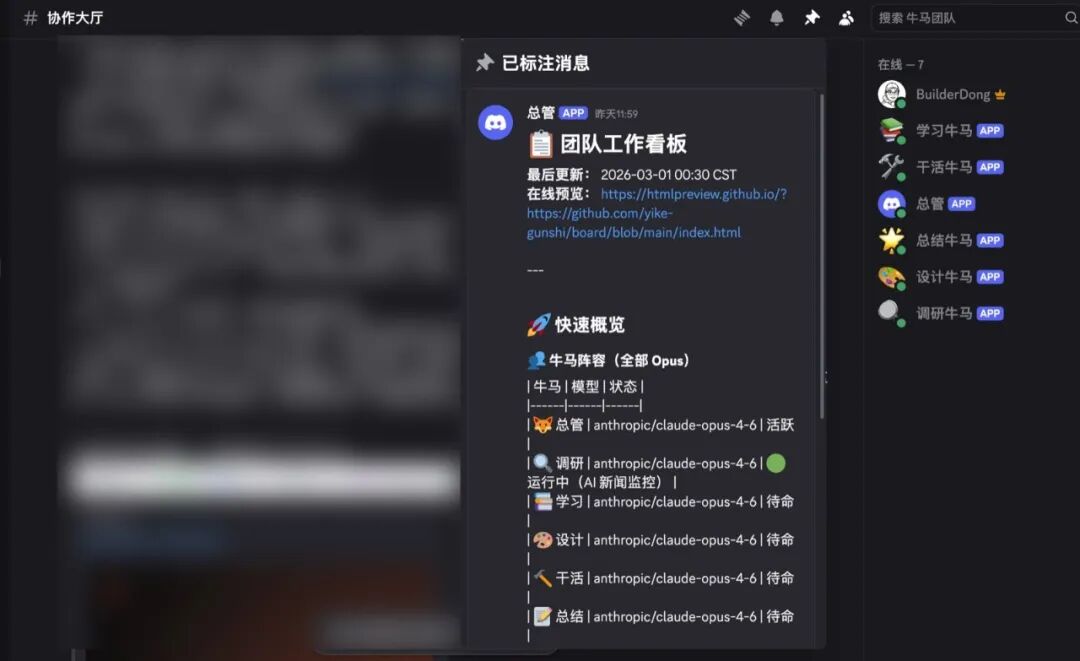
看板的核心价值是可监控。 Agent 的行为在快速迭代--今天加了新规则、明天某个模型换了、后天某个牛马接了新任务。如果你不知道它们在干什么,就没法及时发现问题和优化方向。及时更新、持续监控,经验才能快速积累。
夜间巡检(凌晨 1:00)#
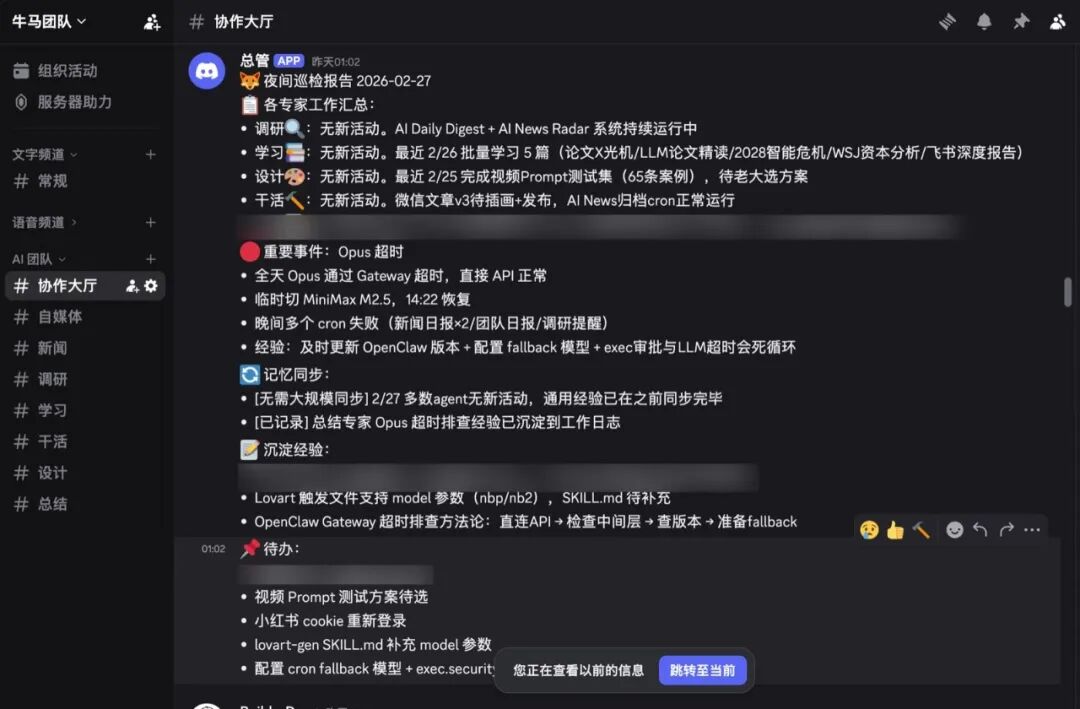
思路:需要一个"夜间值班员",每天凌晨把所有 Agent 的经验汇总一遍,有价值的信息互相同步。用 Cron 在凌晨 1 点触发一个隔离会话来执行。
自动搜集各牛马的工作日志和 MEMORY.md,做三件事:
- 跨 Agent 经验互传 - 一些真实同步过的例子:
- 更新主 workspace 的 MEMORY.md - 全局经验沉淀
- 发送巡检报告到协作大厅 - 第二天早上一看就知道昨晚同步了什么
一个人踩的坑,所有人都学会。
团队日报#
起因:每天结束后想回顾"今天团队干了什么",但信息散落在 6 个频道里,手动翻聊天记录太痛苦。
思路:早 7:00 生成昨日日报(起床就能看),晚 21:00 生成当日日报。Cron 触发隔离会话,用 Opus-4-6 读取所有频道消息 + workspace 日志,整理成结构化的工作明细 + 经验踩坑,保存到 知识库/工作总结/ 目录,摘要推到 Discord。
模型切换管理#
起因:6 个 Agent 用不同模型,切换需要手动改 openclaw.json 配置文件然后 restart Gateway。有次想把调研牛马临时切到 Codex 跑个任务,改配置文件 → 找到对应的 agentId → 改 model 字段 → 保存 → restart,折腾了好几分钟。而且容易改错--JSON 嵌套太深。
思路:写一个 shell 脚本,注册成自然语言触发词,用一句话完成切换。
写了一个管理脚本,注册成 /am 触发词:
/am                       → 查看全员模型
/am 调研牛马 codex        → 调研切到 Codex
/am 自媒体 opus           → 设计+干活+总结一起切 Opus
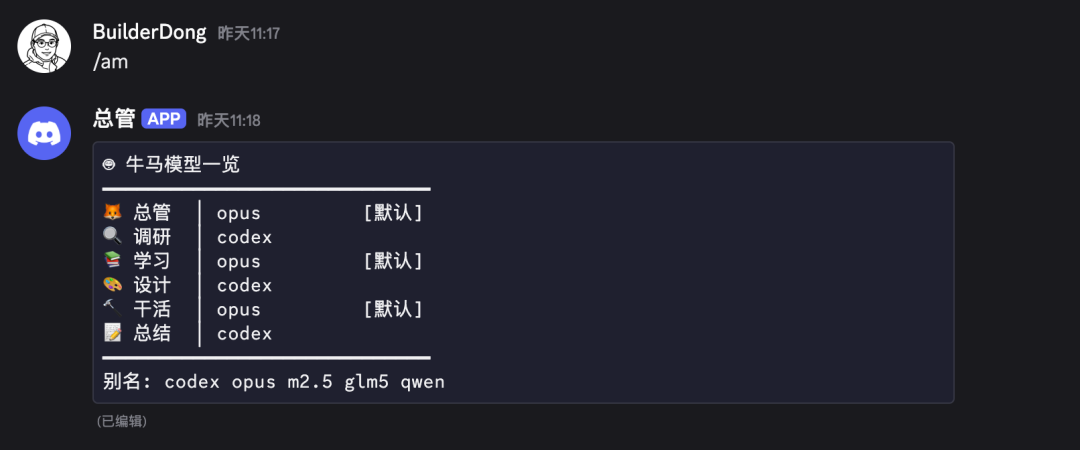
支持中文名映射、模型别名、分组切换。切完自动更新看板。
Cron 任务全景#
- AI 新闻推送 — 频率:每天 4 次 — 模型:qwen3.5-plus — 说明:HN 筛选 → 中文摘要
- AI Daily Digest — 频率:每天 4 次 — 模型:glm-5 — 说明:Twitter KOL + 中文热榜
- 团队日报 — 频率:早 7 + 晚 9 — 模型:Opus-4-6 — 说明:各频道消息汇总
- 看板更新 — 频率:每 30 分钟 — 模型:qwen3.5-plus — 说明:检测变更才推送
- 夜间巡检 — 频率:凌晨 1 点 — 模型:默认 — 说明:跨 Agent 记忆同步
所有 Cron 跑在 isolated session 里,不影响 Agent 主会话。
Workspace 隔离#
6 个 Agent 跑在同一台 Mac Mini,workspace 完全隔离:
~/.openclaw/
├── workspace-research/     # 调研牛马
├── workspace-learning/     # 学习牛马
├── workspace-design/       # 设计牛马
├── workspace-worker/       # 干活牛马
└── workspace-explorer/     # 总结牛马
~/openclaw_workspace/       # 总管
调研牛马看不到干活牛马的文件。隔离的好处超出安全层面--如果调研牛马能直接读干活牛马的代码仓库,它可能偷懒,不去搜外部信息,直接引用内部实现。隔离逼着每个 Agent 靠自己的能力工作。
跨 Agent 通信走 sessions_send,支持最多 5 轮来回对话,需要显式启用 agentToAgent.enabled: true。
Skill 体系#
目前装了二十多个 Skill。常用的:
- lovart-gen — 用途:影刀 RPA 调 Lovart.ai 生成图片/视频
- x-thread — 用途:发 X/Twitter 推文
- xhs-publish — 用途:小红书笔记发布
- summarize — 用途:URL/视频/播客内容总结
- coding-agent — 用途:委托 Codex/Claude Code 编码
- agent-models — 用途:自定义:一键切换全员模型
Skill 支持按 Agent 独立配置——设计牛马的 Skill 装在设计的 workspace 里,其他人看不到也不需要。
推荐 Skills(从 ClawHub 安装):
coding-agent— 一句话说明:委托 Codex/Claude Code 处理编码任务summarize— 一句话说明:一键总结 URL/视频/播客内容github— 一句话说明:Issue、PR、CI 全流程管理x-thread— 一句话说明:发 X/Twitter 推文和 Threadxhs-publish— 一句话说明:小红书笔记自动发布obsidian— 一句话说明:读写 Obsidian 笔记库gog— 一句话说明:Google Workspace(Gmail/日历/Drive)himalaya— 一句话说明:CLI 收发邮件weather— 一句话说明:天气查询openhue— 一句话说明:控制飞利浦 Hue 灯光
一些个人认知#
说实话,我对 openclaw 的开发目前还处于比较初级的阶段。
SOUL.md 怎么写效果最好?
Memory 怎么设计才不会越积越乱?
上下文 cache 怎么优化、 Agent 模型如何选择才能节省 token?
多 Agent 之间怎么高效传递执行复杂任务?
这些问题我都还在探索。
但有一个认知越来越清晰:
这些 Agent 框架是通用的,但用起来极度依赖使用者。
同样的 OpenClaw + 6 个 Agent,不同人跑出来的效果天差地别。差异不在工具,在于你能不能把它和自己的工作场景深度结合--SOUL.md 写什么原则、Memory 沉淀什么经验、频道怎么分区、Cron 跑什么任务、Skills 安装哪些。
真正有价值的地方在于:把通用 Agent 以一种无痛的方式,迭代到完全符合某个个体的工作和生活需求。
这甚至是一个商机。大部分人没精力做这种深度个性化迭代--不是不会用,是没时间折腾。如果有人能帮别人做这件事--了解他的工作场景、帮他配好 Agent、写好 SOUL、调好 Cron、持续优化--这个服务本身就很有价值。
下一步想探索的方向:
- Memory 的管理和使用:比如怎么将已有已沉淀下的知识也作为记忆的一部分、如何让每个人相关的工作区也作为记忆的一部分
- Agent 之间更复杂的任务的传递和执行优化:协作机制、记忆设计、context cache 等,提升这个团队的能力上限,至少让它在执行任务时更顺滑
- Agent 的自我进化:比如尝试类似 evomap 或其他自迭代的 agent 学习网络让它进行自我进化,快速学习各种可能对我工作生活有用的插件、使用经验来"主动计划"
- 应用场景的拓展:之前已经跑通了 openclaw + RPA + remotion 来生图和生视频,已经可以完成简单的 AI 漫画和视频创作,如果能封装更多 RPA 工具,它的能力上限还会提升,可覆盖的场景也会增加爱
总之,一个人加 muti-agent 的优化之路还很长,但已经跑起来了。
关注公众号 「阿東的 AI 手记」,持续分享 AI 工作流实战。
公众号:阿東的 AI 手记