这几个万星 Skill 研究完后,我造了个加强版,附仓库链接
为什么你用的 Skill 效果一般?我研究了几个万星框架后找到了答案(附优化版Skill)
目录
- 01Skill 的价值被低估了
- 02当前几个爆火的 Skill 框架
- Superpowers — 120k+ ⭐
- gstack — 54k+ ⭐
- OpenSpec — 35k+ ⭐
- autoresearch — 2.7k+ ⭐
- 03为什么我要做一套自己的 Skill 框架
- 04Forge 全景
- 05实战:假设你要做一个"用户反馈看板"
- Step 1:/forge-brainstorm — 你说想法,它帮你想清楚
- Step 2:/forge-prd — 把想法变成可执行的需求文档
- Step 3:/forge-design — 不是让你描述"好不好看",而是直接给设计体系
- Step 4:/forge-eng — 读 DESIGN.md,分 Wave 写代码
- Step 5:/forge-qa — 打开页面真操作,不是看代码猜
- Step 6:/forge-fupan — 复盘,跟 AI 一起进步
- 06Forge 融合了什么、原创了什么
- 07安装和使用
- 08最后聊聊我对人机协作的一些认知
大家好,我是阿东。
最近在做一个全栈项目,借着 Claude Max 的 2 倍 token 福利狠狠迭代了一下工作流程,顺便把 Superpowers、gstack 这几个万星 Skill 框架拆了一遍。
本文分享下研究心得,也把我自己优化后的 Forge Skill 框架开源了,仓库地址见文章末尾。
Skill 的价值被低估了#
Skill 是一套结构化的指令文件,放在特定目录下,AI 编程工具在每次对话时会自动加载。一个完整的 Skill 目录长这样:
my-skill/
├── SKILL.md           ← 核心指令文件(角色、流程、规则、约束)
├── references/        ← 参考文档、模板、示例
├── scripts/           ← 可执行脚本(Python、Bash 等,AI 运行时可调用)
└── data/              ← 数据文件(CSV、JSON 等)
SKILL.md 是唯一必需的文件,正文部分是具体的指令和流程。除此之外你可以放任何支撑文件——模板、示例输出、脚本、数据集。SKILL.md 通过引用这些文件来告诉 AI 什么时候用、怎么用。
目前 Claude Code、Codex、Cursor 等主流 AI 编程工具都支持这种机制。甚至 OpenClaw 在最新版本中也兼容了 SKILL.md 格式。Skill 正在成为跨工具的通用标准。
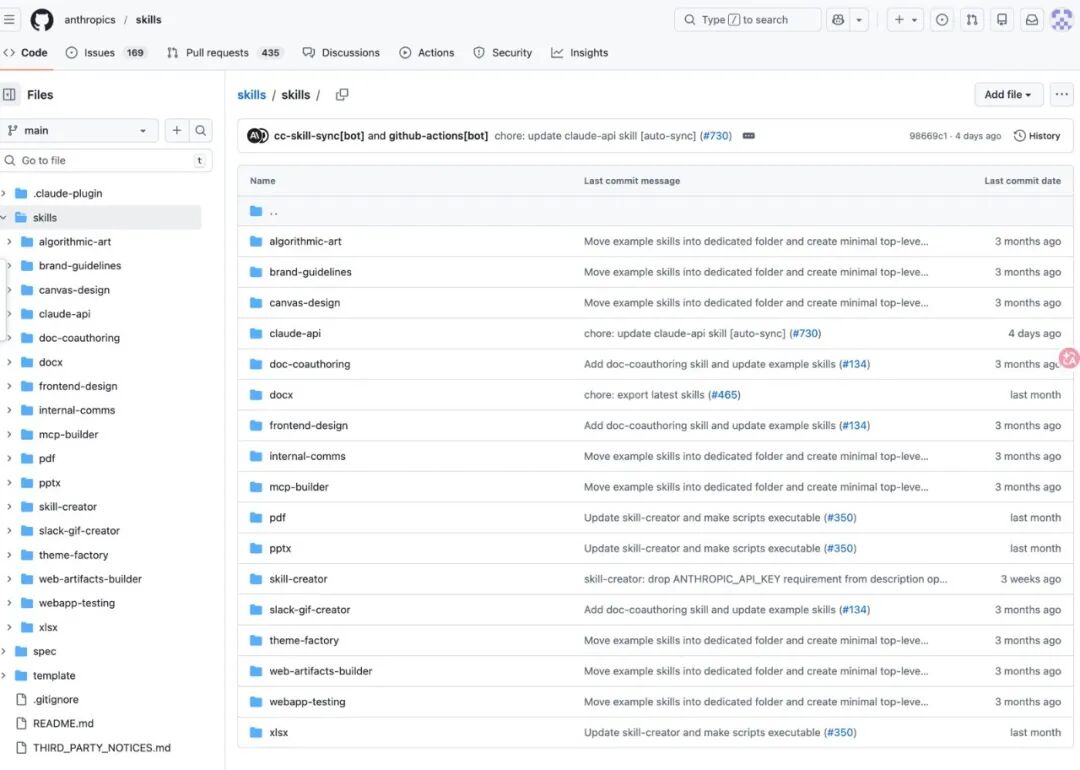
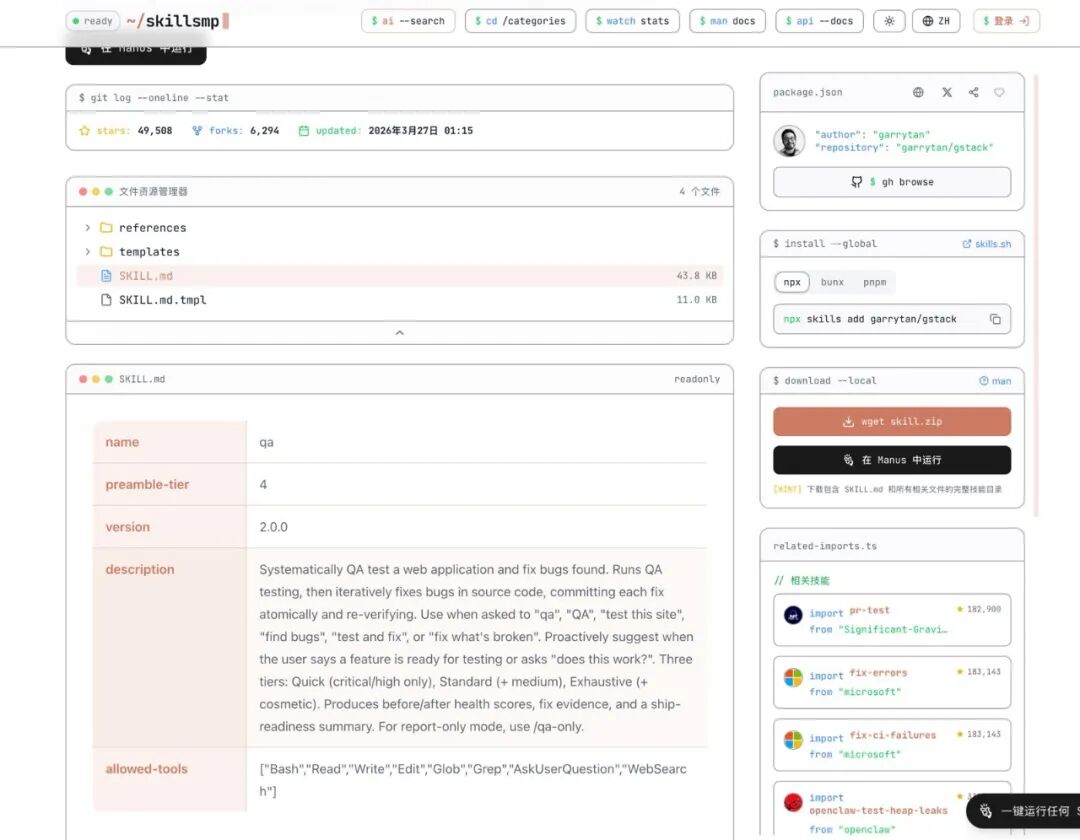
之前我使用 Skill 的方式是,遇到自己不懂但又想借助最佳实践(如前端开发、UI/UX)时,直接上 Claude 官方 Skill 仓库或者 SkillsMP 搜一下,找个 Star 多的直接用。
但总感觉效果一般——这些 Skill 很多都是通用规则驱动的,很难适配个性化场景。
直到我认真拆了 Superpowers、gstack 这几个万星项目之后,发现这玩意很值得投入精力去不断迭代和完善,定制适合自己的 SOP 是非常高 ROI 的事情!
简单来说,如果 LLM 是通过对互联网知识抽象和蒸馏后得到的最强大脑,那 Skill 就是在这个最强大脑上的一层最佳实践约束——好的 Skill 通过"规范 + 流程驱动",可以帮助我们极大地发挥大模型的能力,快速提升任何领域的交付效率和质量。
两年前我们通过在 Prompt 中添加关键词让 LLM 快速 get 到关键词所在向量空间附近的知识来提升模型的智能,进而提升模型输出质量。
现在我们通过 Skill 提供大量的关键词、规范、脚本、甚至完整的工作流程来提高它的交付水平。
本质上也是一种高阶的 Engineering——不论它叫 Prompt Engineering、Context Engineering 还是 Harness Engineering,都是在 LLM 之外的一层脚手架,只是从"一句话提示"进化成了"一整套方法论"。
举个例子,模型本身的智能是会飘忽不定的。它可能在应该用框架 A 的时候用了框架 B,然后就顺着这个方向一直走下去了。
但如果加载了一个了解该领域最佳实践的 Skill,可能 SKILL.md 中的关键词、reference 中的模板、script 中的某个固定操作,都能让它在正确的方向上持续工作并产出高质量结果。
Anthropic 最近发了一篇工程博客《Harness Design for Long-Running Application Development》,也在说这件事。比如从 Opus 4.5 升级到 4.6 之后,他们原来工程链路上的一些脚手架拆掉了,但用于计划和质量评估的 planner 和 evaluator 仍然有价值。
他们的结论是:给 AI 搭脚手架,即使模型越来越强,脚手架也不会消失。
模型变强了,Skill 该管的事情也跟着变,但这类脚手架值得持续投入。
当前几个爆火的 Skill 框架#
接下来聊几个我仔细研究过的 Skill 框架,只分享我看到的设计亮点和各自的侧重点,每个都值得你单独深入去了解。
Superpowers — 120k+ ⭐#
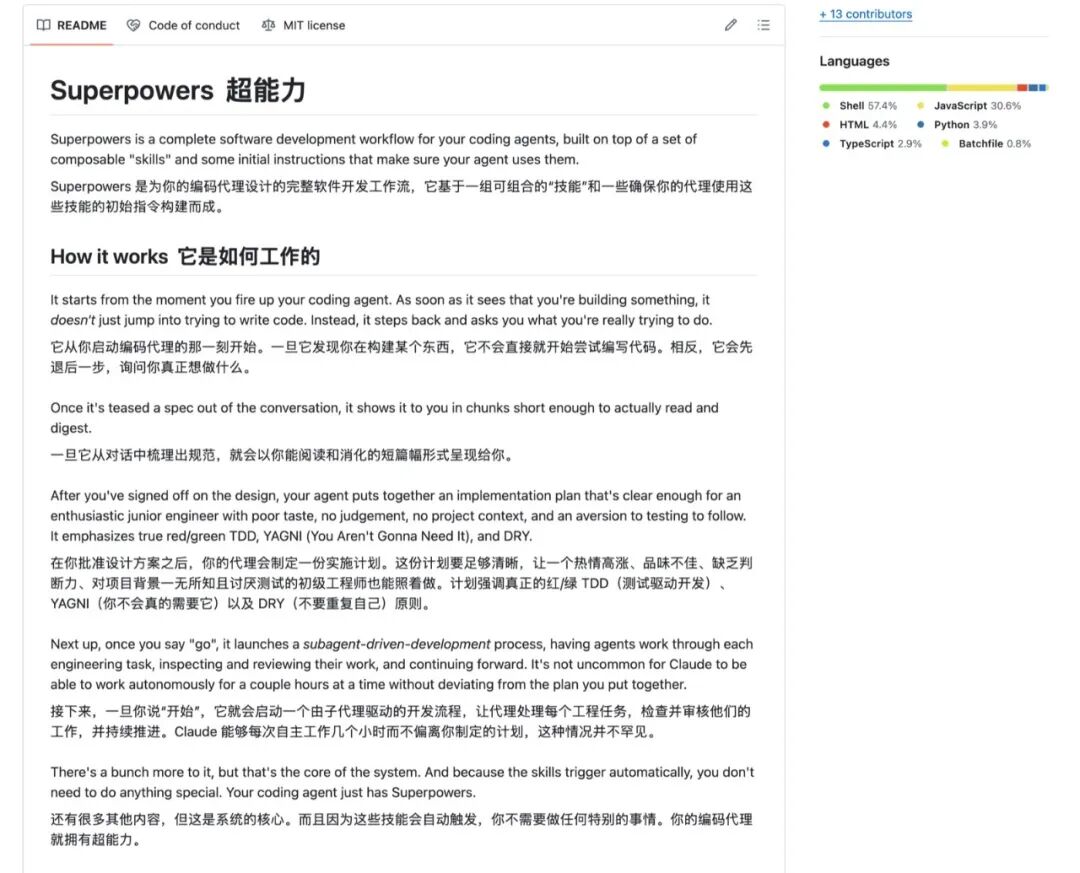
Superpowers 是目前 Star 数最高的 Skill 框架。14 个 Skill 从 brainstorming 到 code review 覆盖完整开发周期,通过强约束来管控 AI 的行为。
虽然定位在软件开发,但很多设计思想是通用的——比如 Verification Gate(做完必须给证据)、三振出局(修三次还不行就质疑方向)。这些约束放在写文档、做方案、甚至日常任务管理里一样有用。
几个让我印象深刻的设计:
- Brainstorming:不只是帮你发散,还会结构化地追问、质疑、提供方案对比。几乎适配所有场景——不仅限于写代码,做方案、做决策、写文档都能用。
- Git Worktree 隔离:每个开发任务在独立的 Worktree 中执行,互不干扰。多任务并行时不会互相踩代码。
- Verification Gate:每次声明"完成"之前,必须提供证据(命令输出 + exit code)。不允许说"应该可以"就交差。
- TDD 红绿重构:内嵌测试驱动开发流程,先写测试再写实现。
- 三振出局(3-strike rule):同一个问题修了三次还没好,强制停下来质疑架构,而不是继续在错误方向上打补丁。
Superpowers 的哲学是"路径约束"——明确告诉 AI 什么不能做,通过限制自由度来保证质量。
适合场景:纯工程开发,特别是对代码质量要求高的项目。
gstack — 54k+ ⭐#
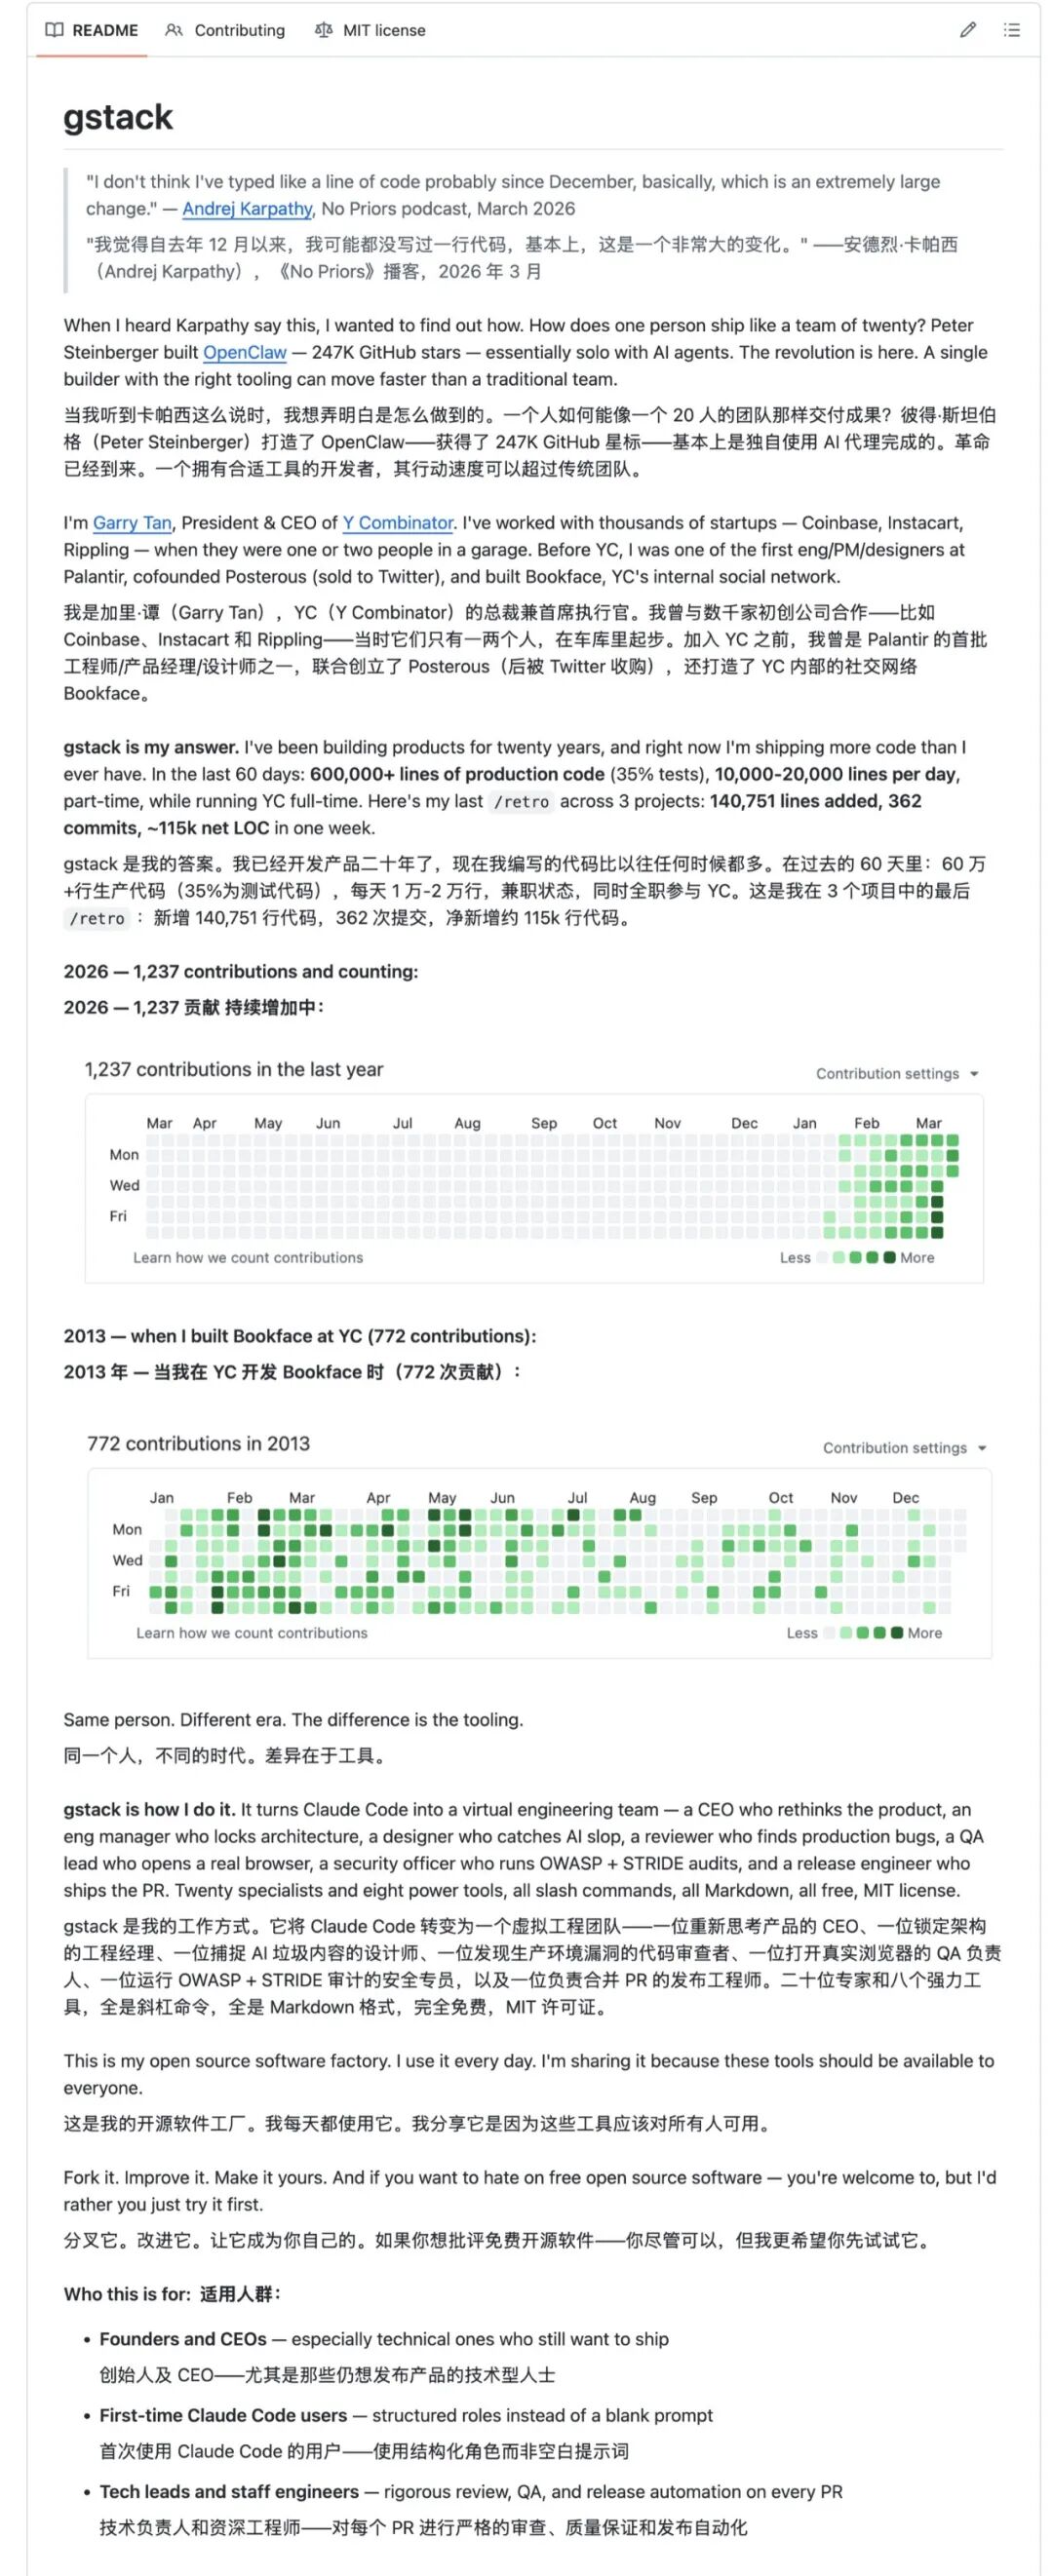
作者 Garry Tan,Y Combinator 现任 CEO。这个背景决定了 gstack 的视角不是"程序员怎么写代码",而是"一个 CEO 怎么带团队做产品"。
gstack 的核心思路是角色模拟——15 个 Skill,每个扮演一个团队角色:CEO、设计师、工程经理、发布经理、文档工程师、QA 工程师……用 AI 模拟了一个完整的工程团队。
几个我觉得设计得好的点:
- office-hours:模拟 CEO 办公时间,用 6 个强迫性问题(forcing questions)来审视你的想法。反谄媚——不会顺着你说"好主意",而是会追问"你确定吗?你想过这个失败了会怎样?"
- plan-ceo-review:用"梦想状态映射"、"反转思维"、"最窄楔子"等思维工具来审查产品计划。
- browse:内置 headless browser 引擎,能直接导航页面、截图、点击交互,用于 QA 测试和设计验收。不是看代码,是真的打开页面去操作。
- 设计三件套:design-consultation → design-review → design-shotgun,从调研到评审的完整链路。
相比 Superpowers 的"纪律型",gstack 更像"产品型"——不只关心代码对不对,还关心产品方向对不对、设计好不好、发布流程顺不顺。
另外 gstack 不是纯 Prompt,还有大量 TypeScript 代码(browse 引擎、Chrome 扩展、Supabase 后端),是 Prompt + 工程的结合。
适合场景:产品驱动的全栈开发,独立开发者或小团队想模拟完整团队分工。
OpenSpec — 35k+ ⭐#
核心理念是 Spec-driven Development(规格书驱动开发)——写代码之前先写一份结构化的规格书,AI 基于规格书实现,减少幻觉和方向偏离。
思路上和 Forge 的"文档驱动"有相似之处,但 OpenSpec 更聚焦在"规格书"这一个环节,不覆盖设计、QA、复盘等后续链路。
autoresearch — 2.7k+ ⭐#
受 Andrej Karpathy 的 autoresearch 概念启发,核心是自主迭代循环:修改 → 验证 → 保留/丢弃 → 重复。适合需要反复实验、逐步逼近目标的研究型任务。定位跟前面几个不同,不是开发流程管理,是实验循环自动化。
这些框架都非常好,各有侧重。如果你还没用过 Skill,建议先去看看 Superpowers 和 gstack,感受一下好的 Skill 长什么样。
但我在实际使用过程中,发现了一些个人场景下的痛点——这也是 Forge 诞生的原因。
为什么我要做一套自己的 Skill 框架#
第一,没有一个框架覆盖了我需要的全链路。
我的工作不只是写代码。
一个功能从想法到上线,我需要:头脑风暴 → 写 PRD → 设计 → 工程实现 → QA 验收 → 代码审查 → 发布 → 复盘。Superpowers 只覆盖了一部分(brainstorm → plan → code → test → review),gstack 有设计和产品审查,但也没有把整个链路串联起来。
我需要一个从"我有个想法"到"功能上线并且我学到了东西"的完整闭环。
第二,约束太一刀切了。
Superpowers 的"路径约束"哲学——明确告诉 AI 什么不能做——在工程阶段很有效。但如果 brainstorm 阶段也用这套,就变成了"你想自由探索,AI 说不行"。不同阶段需要不同松紧度。
Forge 的做法是:brainstorm 阶段放开,给 AI 足够的自由度去发散;到了工程阶段,用 Worktree 隔离 + TDD + Verification Gate 来把控质量。
第三,我需要解决上下文衰减问题。
这是我在实际开发中反复碰到的:一个复杂功能如果在一个会话里从头做到尾,后半段的输出质量会明显下降。模型开始跳过验证、开始说"应该可以"、开始遗漏需求。
Forge 的做法是:用一个"调度器"Skill 来编排工作流,调度器只用 30% 的上下文(只处理摘要和决策),每个子任务(设计、工程、QA)都在独立的新会话中执行,拿到 100% 的上下文窗口。子任务之间通过文档传递信息,不通过会话历史。每个环节都拿到最新鲜的上下文,质量不会因为前面聊了太多而衰减。
第四,也是我觉得最最最最重要的——需要一个复盘机制。
这点没有任何一个现有框架在做。
如果你只是驱动 AI 干活,干完就走,那你永远只会那几个关键词。 你不知道自己哪里表达不清楚,不知道哪些地方可以更精准,不知道 AI 在哪个环节容易出问题。
“不知道自己不知道”是 AI 时代的原罪。
所以 Forge 里有一个叫 forge-fupan 的 Skill,做的就是这件事:每次做完一段工作,拉着你一起回顾——AI 哪里做得好、哪里做得差、你自己哪里表达不清楚。然后把经验沉淀下来,反哺到 Skill 的迭代中。
说一个真实的例子。
做项目的时候,有个环节是让 AI 给每条信息打分。跑了几轮,分数一直不对——Karpathy 发的 autoresearch 一周 3 万星,AI 只打了 6.8 分。我第一反应是去调权重表,改公式、换系数,改了三轮越来越离谱。
后来我跑了一次复盘。复盘过程中它问了一个问题:"LLM 打分时实际收到了哪些输入?"
我去看了传给模型的 prompt,发现它根本看不到作者信息、Github star 数、X 的互动数,所以 Karpathy 的帖子和其他人转发帖子在模型眼里没有区别。复盘过程中才被 LLM 告知问题不在权重表,在输入。 如果没有这次复盘,我要么自己想明白,要么还在瞎调参数。
当时在复盘文档里沉淀下来的关键信息长这样:
零成本信息增强优先:优先把数据库里已有但没传给 LLM 的字段(作者、互动、来源)加到 prompt 里,比 web search enrichment 成本低、效果立竿见影。
分类边界对齐用户心智模型:分类标准跟用户的认知走——"我在用的 = tools,不认识的 = products",而非学术定义。一句"tools vs products 按用户使用关系分"就校准了分类。
下次这样告诉 AI:评分不准时,第一步先看 LLM 实际收到的输入是不是全面(print prompt),而非调权重。
还有一次,我让 AI 实现一个瀑布流入场动画。文字描述了半天"从上往下、错落有致、渐进出现",做出来完全不是我想要的。复盘后我给自己加了一条规则:涉及视觉效果,直接甩参考网站链接,不用文字描述。 一个链接胜过一百字。
这些都不是 AI 教我的,是复盘这个过程逼我回到问题原点后,自己慢慢想明白的。
forge-fupan 意味着你不是在消费 AI 的能力,你是在跟它一起成长。 下次碰到类似场景,你的表达更精准,它的输出也更准确。这个正向循环是我觉得 Forge 里最有价值的一个设计。
Forge 全景#
说完为什么做,说说 Forge 这套 Skill 框架长什么样。
整个系统 14 个 Skill + 1 个总入口,覆盖从想法到发布到复盘的完整生命周期:
用户有想法
       │
       ▼
  ┌─────────────────┐
  │ forge-brainstorm │  头脑风暴(4 种模式:产品·内容·构建·探索)
  └──────┬──────────┘  反谄媚 + 对抗性审查,不会顺着你说好
         │
         ▼
  ┌──────────┐
  │ forge-prd│  产品诊断 → PRD 迭代
  └────┬─────┘  三层自适应审查(轻量 / 标准 / 深度十星挑战)
       │
       ▼
  ┌──────────┐
  │ forge-dev│  开发调度器:拆分任务 → 调度子 Skill
  └────┬─────┘  每个子任务独立上下文,不共享会话历史
       │
  ┌────┼────────────────────────┐
  ▼    ▼                        ▼
┌──────────┐ ┌───────────────┐ ┌──────────┐
│  forge-  │ │ forge-design- │ │  forge-  │
│  design  │ │     impl      │ │   eng    │
└──────────┘ └───────────────┘ └──────────┘
  设计规划     设计 → 代码        工程实现
  自闭环       反 AI 模板        Worktree 隔离
  99 条 UX     Token 驱动        TDD + 验证门
  规则审计
       │
       ▼
  ┌──────────┐   ┌──────────┐   ┌──────────┐
  │ forge-qa │ → │  forge-  │ → │  forge-  │
  └──────────┘   │  review  │   │   ship   │
   纯验收测试    └──────────┘   └──────────┘
   不修代码       代码审查        发布流程
   10 维度断言    结构性问题      合并+测试+PR
       │
       ▼
  ┌──────────┐
  │  forge-  │  复盘 → 知识沉淀 → 反哺 Skill 迭代
  │  fupan   │  你和 AI 一起进步的关键环节
  └──────────┘
随时不知道下一步?输入 /forge → 检查项目状态,告诉你该做什么
每个 Skill 一句话说明:
总入口与编排
- forge — 总入口,检查项目状态,推荐下一步
- forge-dev — 开发调度器,拆分任务,半自动编排子 Skill
- forge-deliver — 端到端编排,调用所有子 Skill,支持全自动和从检查点恢复
前期探索
- forge-brainstorm — 头脑风暴,4 种模式,6 个阶段,反谄媚 + 对抗性审查
- forge-prd — PRD 管理,三层自适应审查,支持从零创建和迭代
设计与实现
- forge-design — 全栈设计规划,自闭环(竞品调研 + 美学方向 + 配色字体搜索引擎 + 99 条 UX 规则审计 + 0-10 评分)
- forge-design-impl — 设计转代码,反 AI 模板,Token 驱动样式,原子提交
- forge-eng — 工程实现,Worktree 隔离 + 四级 TDD + Verification Gate + Wave 并行
质量与发布
- forge-qa — 纯验收测试(不修代码),三种测试引擎,10 维度断言
- forge-bugfix — 系统性 Bug 调查,六阶段根因分析,铁律:不做根因分析不写修复代码
- forge-review — 代码审查,专注结构性问题(SQL 安全、竞态、LLM 信任边界)
- forge-ship — 发布流程:合并 → 测试 → CHANGELOG → PR
- forge-doc-release — 发布后文档同步
复盘
- forge-fupan — 复盘与知识沉淀,诊断 AI 和用户双方表现
几个核心设计理念:
充分讨论是最高 ROI 的事情。 充分讨论 → 充分设计 → 才写代码。未经过充分讨论和设计时,后期改代码的成本是前期改文档的十倍,随着模型能力的提升,70% 讨论设计、10% 开发、10% 验收的时间分配变得 work 了。
文档是源代码的上游。 PRD 变更驱动代码变更,不是反过来。想改功能?先改 PRD,再改代码。
证据先于断言。 不说"应该可以"——Verification Gate 要求每个完成声明都附带证据(命令输出 + exit code)。
原子化一切。 每个任务独立 commit,可追溯、可回滚。不会出现"改了十个文件但不知道哪个改坏了"的情况。
实战:假设你要做一个"用户反馈看板"#
光说设计理念还是抽象。假设你现在要给自己的产品加一个用户反馈看板——收集用户反馈、分类、按优先级展示、支持标记处理状态。看看用 Forge 走一遍完整链路,每一步你输入什么、得到什么。
Step 1:/forge-brainstorm — 你说想法,它帮你想清楚#
你的输入:
我想做一个用户反馈看板,把各个渠道的用户反馈收集起来,分类展示,能标记处理状态。
forge-brainstorm 不会直接说"好的我来帮你做",它会先追着你问,然后产出一份完整的思考文档:
# 头脑风暴:用户反馈看板
**日期**
:2026-03-29
**模式**
:产品
**状态**
:草案
## 背景
用户想做一个反馈收集+看板系统,多渠道聚合,分类展示,状态管理。
## 关键发现
### 深度提问摘要
-
 反馈来源:邮件、Discord、微信、App Store?格式不同,怎么统一?
-
 分类方式:手动分还是 AI 自动分?分类体系谁定义?
-
 使用者:只有你自己还是团队?决定了权限模型的复杂度。
### 前提挑战
-
 MVP 阶段不要同时做多个渠道——复杂度会爆炸
-
 "分类"和"优先级"是两件事,不要混在一起
## 方案
### 方案 A:最小闭环
-
 先只做 Discord 一个渠道,跑通采集→分类→展示→标记
-
 优点:一周内能上线验证
-
 缺点:只覆盖一个渠道
### 方案 B:全渠道聚合
-
 一步到位,接入 Discord + 邮件 + 微信
-
 优点:覆盖全
-
 缺点:每个渠道的接入方式不同,开发周期 3x
### 推荐与理由
推荐方案 A。先跑通一个渠道的完整闭环,验证分类效果和看板交互,
再扩展其他渠道。
## 对抗性审查
"LLM 自动分类"听起来好,但分类边界模糊时会大量误判。
建议保留人工修正入口,同时用 few-shot 而非 zero-shot 提升准确率。
## 下一步
确认方案 A → /forge-prd 转化为正式需求文档
关键在于——它不是顺着你说,它会质疑你的假设、帮你收窄范围。很多时候你以为想清楚了,其实经不住追问。
Step 2:/forge-prd — 把想法变成可执行的需求文档#
brainstorm 确认方向后,跑 forge-prd,它会产出一份结构化的 PRD:
# 产品需求文档 (PRD)
**版本**
:v1.0
**状态**
:已定稿
## 产品概览
用户反馈看板,通过 Discord Webhook 收集反馈,LLM 自动分类,
看板视图管理处理状态。面向独立开发者。
## 功能模块
### Module 1:反馈采集
-
 Discord Webhook 接收消息
-
 消息解析(文本 + 附件)
-
 去重(基于消息 ID)
### Module 2:智能分类
-
 LLM 自动分类:Bug / Feature Request / Question / Praise
-
 置信度阈值:低于 0.7 标记为"待人工确认"
-
 保留人工修正入口
### Module 3:看板视图
-
 按分类分栏展示
-
 拖拽改状态(待处理 → 处理中 → 已完成)
-
 优先级自动评分(影响用户数 × 严重度)
## 明确不做
-
 多渠道接入(MVP 只做 Discord)
-
 用户登录系统
-
 数据导出
-
 邮件通知
它帮你把"想做什么"和"明确不做什么"都写清楚。"明确不做"这一项对 AI 后续开发特别重要——不写的话,AI 经常会自作主张加功能。
Step 3:/forge-design — 不是让你描述"好不好看",而是直接给设计体系#
# 设计规划文档 (DESIGN.md)
**版本**
:v1.0
## 竞品调研
-
**Linear Issues**
:极简看板,拖拽流畅,状态色彩区分明确
-
**Canny**
:反馈投票机制好,但看板视图弱
-
**Productboard**
:功能强大但过于复杂,不适合个人使用
差异化机会:极简 + AI 分类 + 个人使用场景,竞品都偏团队
## 美学方向:Minimal Warm
-
 配色:主色 #4F46E5(靛蓝)/ 背景 #FAFAF9 / 强调 #F59E0B
-
 字体:DM Sans + Noto Sans SC
-
 适用场景:个人工具,温暖不冰冷
## UX 审计(99 条规则命中项)
-
 #12 拖拽必须有视觉反馈(阴影 + 目标区高亮)
-
 #34 状态标签用颜色 + 文字双重编码(色盲可访问)
-
 #67 空状态必须有引导文案,不能白屏
-
 #81 移动端触控目标最小 44px
## 0-10 交互审查
-
 信息架构 9/10 — 三栏看板,结构清晰
-
 交互状态覆盖 7/10 — 缺少拖拽中的骨架屏
-
 AI模板风险 8/10 — 配色无紫色渐变,通过
我以前做设计,要花很长时间描述"我想要什么风格""这个颜色不对"。现在 forge-design 内置了 161 套配色、57 组字体、99 条 UX 规则,它直接给你选项和规范,你确认就行。
Step 4:/forge-eng — 读 DESIGN.md,分 Wave 写代码#
# 工程方案文档 (ENGINEERING.md)
**版本**
:v1.0
## 架构概览
┌──────────────┐    ┌──────────────┐
│  前端 (React) │←→  │  后端 (Flask) │
│  KanbanBoard │    │  /api/feedback│
└──────────────┘    │  /api/classify│
                    └──────┬───────┘
                           ↓
                    ┌──────────────┐
                    │  SQLite DB   │
                    └──────────────┘
## 实现清单(按 Wave 拆分)
### Wave 1(无依赖,并行)
-
 Task 1: Discord Webhook → webhook.py(签名验证 + 消息解析)
-
 Task 2: LLM 分类 → classifier.py(few-shot + 置信度)
-
 Task 3: 数据库 → models.py(feedback 表 + 状态枚举)
### Wave 2(依赖 Wave 1)
-
 Task 4: 看板前端 → KanbanBoard.tsx(三栏 + 拖拽)
-
 Task 5: API 联调 → 状态更新 + 实时刷新
### Wave 3(依赖 Wave 2)
-
 Task 6: 优先级评分 → scoring.py
-
 Task 7: 暗色模式 → CSS Token 切换
每个 Task 完成后:
✅ 运行测试 + 截取命令输出(Verification Gate)
✅ 独立 git commit(原子化)
✅ Wave 间冲突检测
Wave 1 的三个任务互不依赖,可以并行跑。每个 Task 完成时必须给证据,不能说"改好了"就完事。
Step 5:/forge-qa — 打开页面真操作,不是看代码猜#
# QA 验收报告
**测试方式**
:Playwright 三视口(375px / 768px / 1024px)
## 测试执行结果
### Phase 1: 功能 + API
-
 Webhook 接收 ✅ — 消息解析正确,去重生效
-
 LLM 分类 ✅ — 10 条测试消息,分类准确率 90%
-
 拖拽状态变更 ⚠️ — 空栏目 drop 失败(见下方 Bug)
### Phase 2: 视觉 + 响应式
-
 375px ✅ 纵向排列 + 暗色模式正常
-
 768px ✅ 双栏 + 暗色模式正常
-
 1024px ✅ 三栏 + 暗色模式正常
## 发现的问题
### 🔴 Critical
-
**[Bug-001] 拖拽到空栏目时 drop 事件未触发**
  -
 根因:空栏目高度为 0,无法接收 drop 事件
  -
 修复:min-height: 120px + "拖到这里" 占位文案
  -
 验证:✅ 修复后三视口拖拽均正常
## User Gate
-
 [x] Webhook 接收正常
-
 [x] 分类结果合理
-
 [x] 看板拖拽流畅
-
 [ ] 待用户最终确认
它不是 review 代码猜问题,是真的打开页面去拖、去点、去切暗色模式。 发现了一个我肉眼没注意到的空栏目 bug,自己分析了根因,修了,又验了一遍。
Step 6:/forge-fupan — 复盘,跟 AI 一起进步#
# 复盘:用户反馈看板 MVP
## 一、项目概览
我的需求:做一个 Discord 反馈收集+看板管理工具
AI 做了什么:完成了 Webhook 接收、LLM 分类、三栏看板、拖拽状态管理
最终交付:可运行的 MVP,分类准确率 90%,三视口适配
## 二、知识地图
### 领域 1:LLM 分类
-
**few-shot 分类**
:给 3-5 个标注样例比 zero-shot 准确率高 40%。下次告诉 AI:"用 few-shot,给 5 个 example"
-
**置信度阈值**
:低于 0.7 的分类标记为待人工确认。下次告诉 AI:"加 confidence threshold 0.7"
#### 最佳实践
▍ 分类任务必须给标注样例
-
 做法:每个分类给 3-5 个真实样例,不要只给分类名
-
 为什么:few-shot 比 zero-shot 准确率高 40%
-
 反模式:只给"Bug / Feature / Question"三个词
### 领域 2:HTML 拖拽交互
-
**空容器 drop**
:高度为 0 的容器无法接收 drop 事件。下次告诉 AI:"空栏目要 min-height"
## 三、AI 表现复盘
-
 需求理解 🟢 — PRD 到实现无偏差
-
 自主决策 🟡 — 空栏目 min-height 应该主动加
-
 输出完整度 🟢 — Wave 拆分合理
## 四、用户表达复盘
-
 你说"消息安全" → AI 理解成 HTTPS + 加密 → 精确说法:"Webhook 签名验证"
-
 你说"拖拽功能" → AI 理解成自定义拖拽库 → 精确说法:"HTML Drag and Drop API"
-
 你说"分类" → AI 理解成 zero-shot 分类 → 精确说法:"few-shot 分类 + 标注样例"
复盘还会自动生成可视化的仪表盘图表:
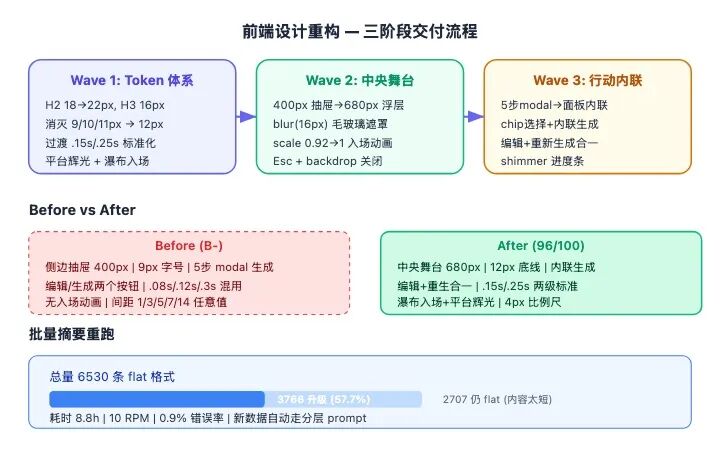
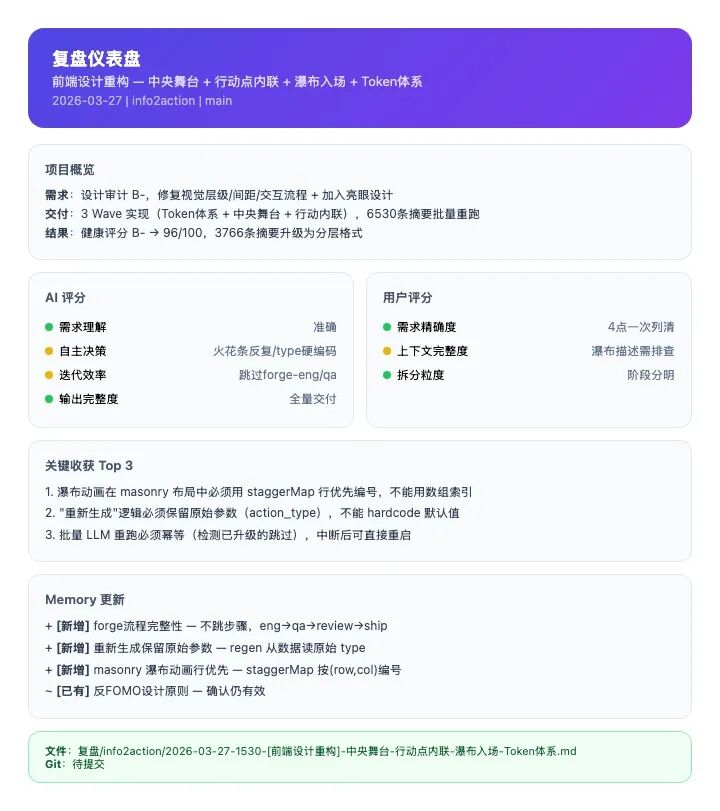
这就是完整的一轮 Forge 链路:你输入一个想法,经过 brainstorm → prd → design → eng → qa → fupan 六步,拿到了思考文档、需求文档、设计体系、工程方案+代码、验收报告、以及一份下次可以直接用的知识沉淀。 每一步的输出都是下一步的输入,全部通过文档串联。
Forge 融合了什么、原创了什么#
最后整理一下 Forge 的"成分表"。
从 Superpowers 学到的理念(重新适配到我的场景):
- Worktree 隔离:每个任务独立 worktree,多任务不冲突
- Verification Gate:完成前必须提供证据
- TDD 红绿重构:Forge 扩展为四级(严格 / 轻量 / 验证驱动 / 跳过),根据项目阶段选择
- 三振出局:修三次不好就质疑架构
从 gstack 学到的理念:
- 反谄媚:brainstorm 阶段不顺着用户说"好主意",会追问、质疑、pushback
- 6 个强迫性问题:审视想法时的结构化提问模板
- headless browser 验收:QA 不看代码,直接操作页面
从设计类 Skill 整合的能力:
- 99 条 UX 规则审计(来自 ui-ux-pro-max)
- 配色 / 字体 / 风格搜索引擎(161 套配色、57 组字体、50+ 设计风格,CSV 数据内置)
- 三层 Token 架构:primitive → semantic → component(来自 CKM Design System)
- 反 AI 模板检测:识别并拒绝"紫色渐变 + 白卡片"这类 AI 生成的典型模板风格
Forge 原创的部分:
- 上下文工程:调度器 30% 上下文 / 子任务 100% 独立上下文,通过文档传递而非会话历史。解决长会话质量衰减问题。
- 复盘闭环(forge-fupan):做完 → 复盘 → 沉淀知识 → 反哺 Skill 迭代,要和 AI 一起成长。
- 文档驱动全链路:PRD.md → DESIGN.md → ENGINEERING.md → QA.md,每个环节的产出都是下个环节的输入,全部通过文档传递。
- 分级门控:不同阶段不同约束力度。brainstorm 阶段放开探索,工程阶段锁死质量。不是"一刀切"的严格或宽松。
- forge-design 自闭环:设计 Skill 内置了竞品调研、美学方向探索、搜索引擎、UX 规则审计、评分体系,不需要外部依赖。
- Wave 并行执行:任务按依赖关系分波——Wave 1 内的任务并行执行,Wave 2 等 Wave 1 完成后才开始,每波之间有验证关卡。
安装和使用#
Forge 已经开源,仓库地址见文末。
两种安装方式:
方式一:GitHub 直接安装
git
clone
 https://github.com/antonailog/forge-skills.git
cd
 forge-skills && ./install.sh
方式二:通过 SkillsMP 安装
npm install -g agent-skills-cli
skills install antonailog/forge-skills --agent claude --
yes
安装完成后新开一个 AI 编程工具的会话,就可以用了。卸载:./install.sh --uninstall
几个快速上手场景:
# 不知道下一步?
/forge           → 检查项目状态,推荐下一步
# 有个新想法?
/forge-brainstorm → 头脑风暴,探索方向
# 要写代码了?
/forge-eng       → 工程实现(含 Worktree + TDD)
# 写完了要验收?
/forge-qa        → 纯验收测试,不修代码
# 做完了想复盘?
/forge-fupan     → 跟 AI 一起回顾,沉淀知识
# 想全自动跑一遍?
/forge-deliver   → 端到端编排(brainstorm → prd → design → eng → qa → review → ship)
比如你启动一个新项目,不确定从哪开始,直接输入 /forge,它会检测你当前目录下的文件状态——有没有 PRD.md?有没有 DESIGN.md?代码改了多少?——然后告诉你"建议先跑 forge-brainstorm"或者"PRD 已经有了,直接用 forge-dev 开始调度"。不用记住 14 个 Skill 的名字,总入口帮你分流。
适用场景:不仅限于写代码——PRD 撰写、产品设计、头脑风暴、技术调研、复盘总结,任何需要结构化工作流的场景都可以用。
适配工具:SKILL.md 格式兼容所有支持 Skill 机制的 AI 编程工具(Claude Code、Cursor、OpenClaw 等)。
最后聊聊我对人机协作的一些认知#
先说说脚手架或 Skill 吧。
我觉得脚手架和最佳实践的逻辑永远会存在,个性化的诉求也是。Skill 这类工具不会消失——它会持续随着模型进化。
可能下一次模型迭代时,模型已经将 Skill 中 Worktree 隔离作为了默认方案。但它是否百分百隔离?怎么讨论出好的方案?怎么从一个想法落地到交付?整个工作流程上怎么管理一个项目?怎么保证稳定性?这些规范层面的问题不会因为模型智能的提升而自动消失,它们要么被模型学习内化,要么持续在外部以脚手架的方式存在。
当然,Forge 这套工具也会跟着迭代,我会不断融合优质实践和方法论到其中。
最后说下最近做这个项目以来,对"人和 AI 怎么一起工作"这件事的一点感悟。
我们在和 AI 交互的过程中,本质不是去不断地点回车,或者不断地 review AI 的输出然后说"这个不对,改一下"。这样你永远只是一个审核员,能力不会有任何增长。
真正有价值的方式是——从每一轮交互中发现自己的知识盲点和表达盲点。
比如之前评分那个例子,调了三轮权重才发现问题在输入——说明我对"LLM 评分需要什么信息"这件事认知不够。复盘帮我把这个盲点挖出来了,我学习到了我表达的问题,以及了解到了关键词。那下一次,我就可以换一种更精准的表达方式。原来可能需要数轮才能完成的一个点,现在一轮就能精准实现。
再比如描述动画那个例子——说明我对"怎么跟 AI 沟通视觉效果"没有好的方法。复盘帮我找到了"甩链接"这个更高效的方式。
不要每一次都用"这个效果不好""那个方向不对"去指导 AI。而是在一轮轮的沟通中,去学到那些自己不知道的知识、不会的内容、未知的领域,比如这一次学会了通过关键词指导,下一次学会了通过链接复刻前端,再下一次学会了通过打开控制台选择元素精准报 bug,这都是实在的进步。在优化工作流程的同时也迭代自己的认知,然后更好地指导 AI,让它帮助你完成更好的工作。
模型在进化,你自己也在进化,这才是 AI 时代成长的好路径。
最后,再放一次上文说的 Skill 仓库地址:https://github.com/antonailog/forge-skills[1]
欢迎提 Issue 和 PR,也欢迎在评论区聊聊你的 Skill 使用经验。
另外如果你对文中提到的这些 Skill 框架感兴趣,我也整理了一份 Superpowers / gstack / OpenSpec / Forge 的详细对照文档——包含每个框架的设计理念拆解、能力对比矩阵、以及我在融合过程中的取舍记录,也许对你自己迭代 Skill 会有帮助。后台回复「skill 对照」,我发给你。
相关链接
Forge 仓库:github.com/antonailog/forge-skills
Superpowers:github.com/obra/superpowers
gstack:github.com/garrytan/gstack
OpenSpec:github.com/Fission-AI/OpenSpec
autoresearch:github.com/uditgoenka/autoresearch
Claude Code Skill 文档:code.claude.com/docs/en/skills
SkillsMP:skillsmp.com
Anthropic 博客:anthropic.com/engineering/harness-design-long-running-apps