你测的 SBTI 人格,原来是这么算出来的
扒开 SBTI 的前端源码:27 种人格怎么判、匹配度怎么算,以及它为什么一天之内刷屏。
目录
大家好,我是阿东。
早上起来一看朋友圈被各种「死者」「吗喽」「小丑」刷屏了。SBTI,Silly Big Personality Test,一个恶搞版的人格测试,一天之内从 B 站一个视频扩散到全网每个角落。
我也测了下哈哈,BOSS,领导者,匹配度 80%。
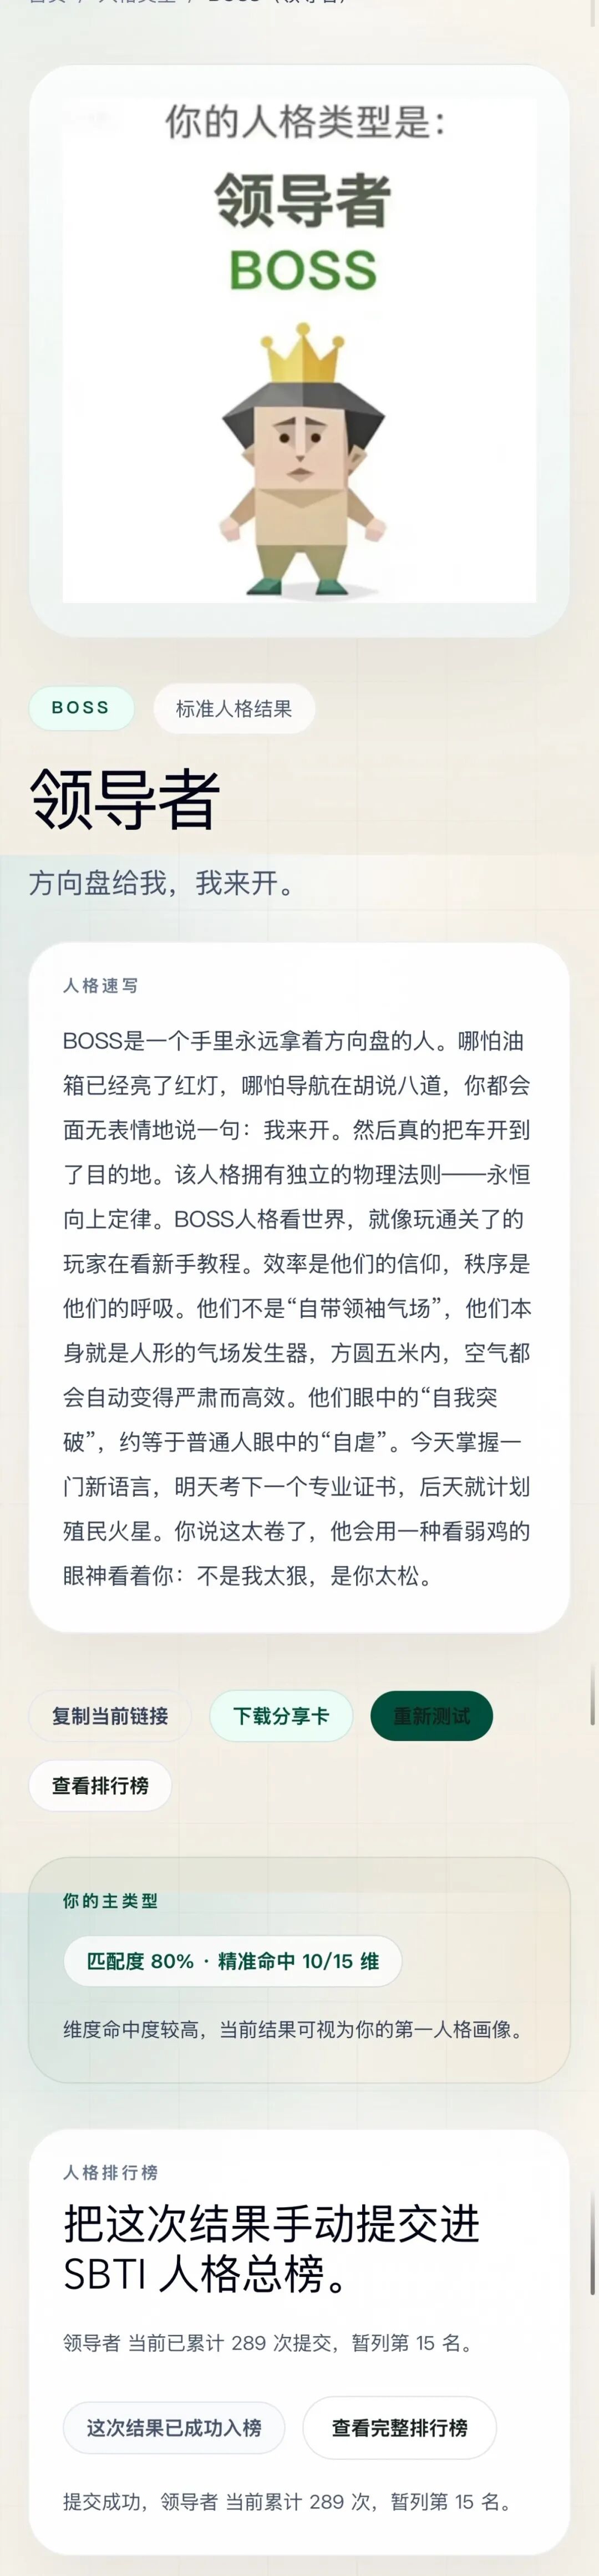
但是看完结果页很好奇这个匹配度、精准命中是咋定义的?毕竟是对自己的一次刻画,合理性还是要了解下的。
所以让 Claude 帮我看了下前端源码,查了公开镜像仓库,把整个实现逻辑搞清楚了。
这篇文章分享下 SBTI 的设计思路和为啥爆火的分析,不管你测没测过,都可以看看,很有意思。
SBTI 是什么#
SBTI 全称 Silly Big Personality Test,直译过来就是"傻乎乎的大人格测试"。
它的创作者是 B 站 UP 主「蛆肉儿串儿」。创作初衷很简单——劝一个爱喝酒的朋友戒酒。
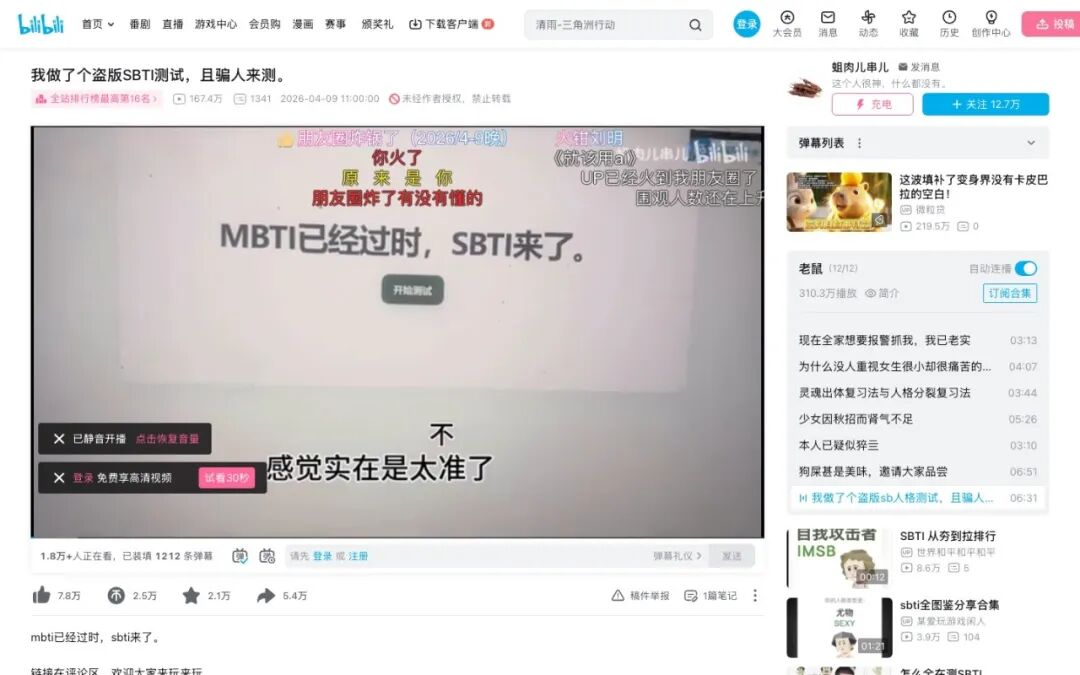
4 月 9 号中午 11 点,她发了一条视频,标题叫「我做了个盗版 SBTI 测试,且骗人来测。」视频里,她骗朋友说这是正版测试,让他做完一套题。朋友做到一半还在吐槽"这简直是胡扯",结果测出来是「酒鬼」人格——一个只有选了"爱好饮酒"才会触发的隐藏人格。
结果页直接列出了酒精对身体的危害:反应变慢、胃痛、肝硬化。朋友看完说"好恐怖啊,我妈是不是找过你"。
视频最后,朋友说了一句:"你竟然如此煞费苦心,我明天开始不喝了。"
就是这个视频。截至我写这篇文章的时候,播放量 167 万,转发 5.4 万,评论 2.7 万。 全站排行最高第 16 名。
怎么测#
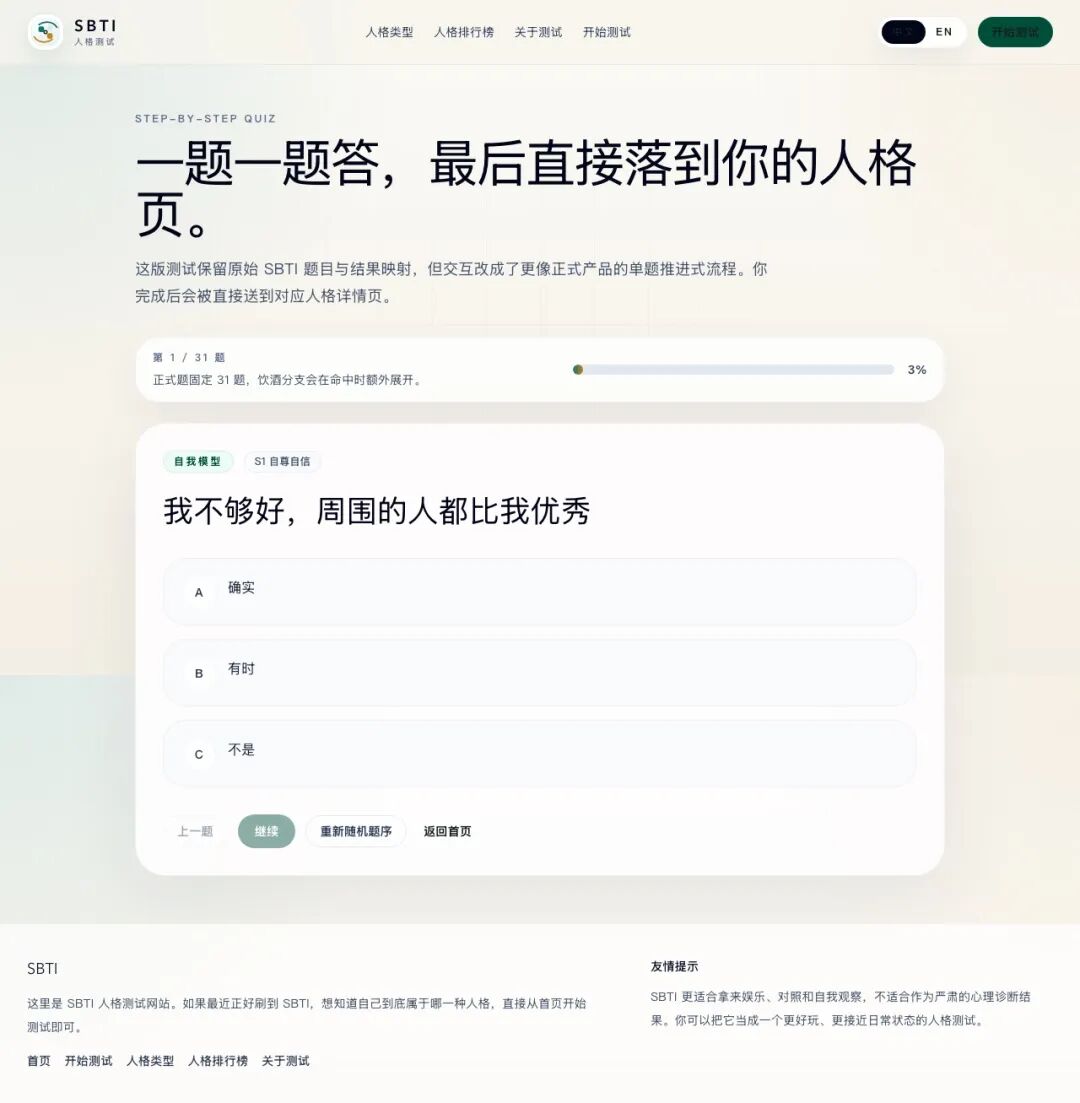
测试入口有很多,官方原版是 sbti.dev,国内访问可以用 sbti.run 或者直接搜"SBTI 测试"。31 道选择题,不需要注册,5 分钟就能填完看到结果。
测的是什么#
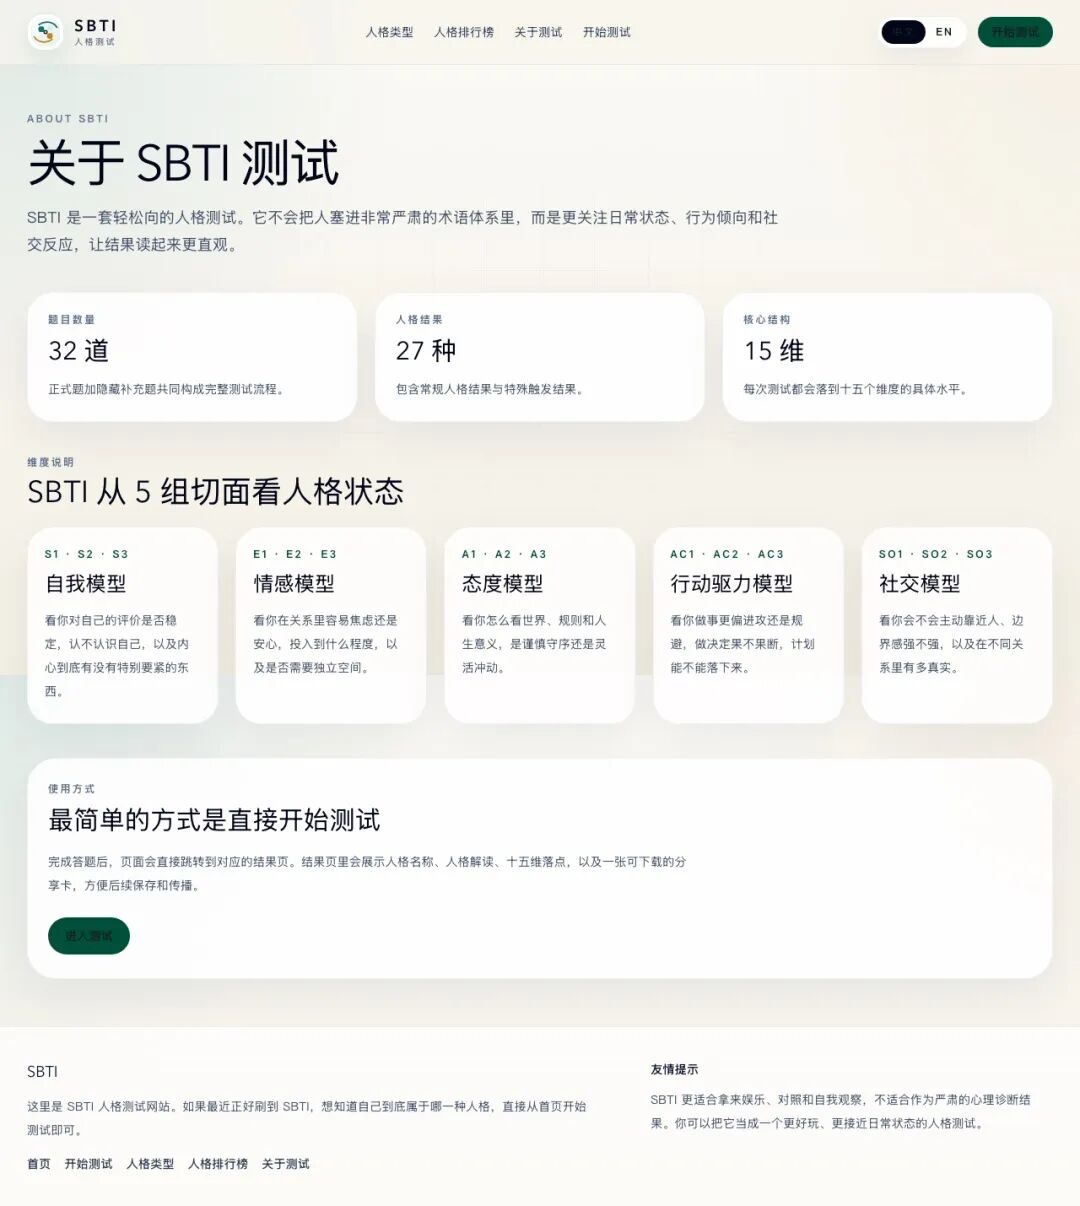
SBTI 把人格拆成了 5 组模型,每组 3 个维度,一共 15 个维度:
- 自我模型(S1-S3):自尊自信、自我清晰度、核心价值
- 情感模型(E1-E3):依恋安全感、情感投入度、边界与依赖
- 态度模型(A1-A3):世界观倾向、规则灵活度、人生意义感
- 行动驱力模型(Ac1-Ac3):动机导向、决策风格、执行模式
- 社交模型(So1-So3):社交主动性、人际边界感、表达真实度
27 种人格#
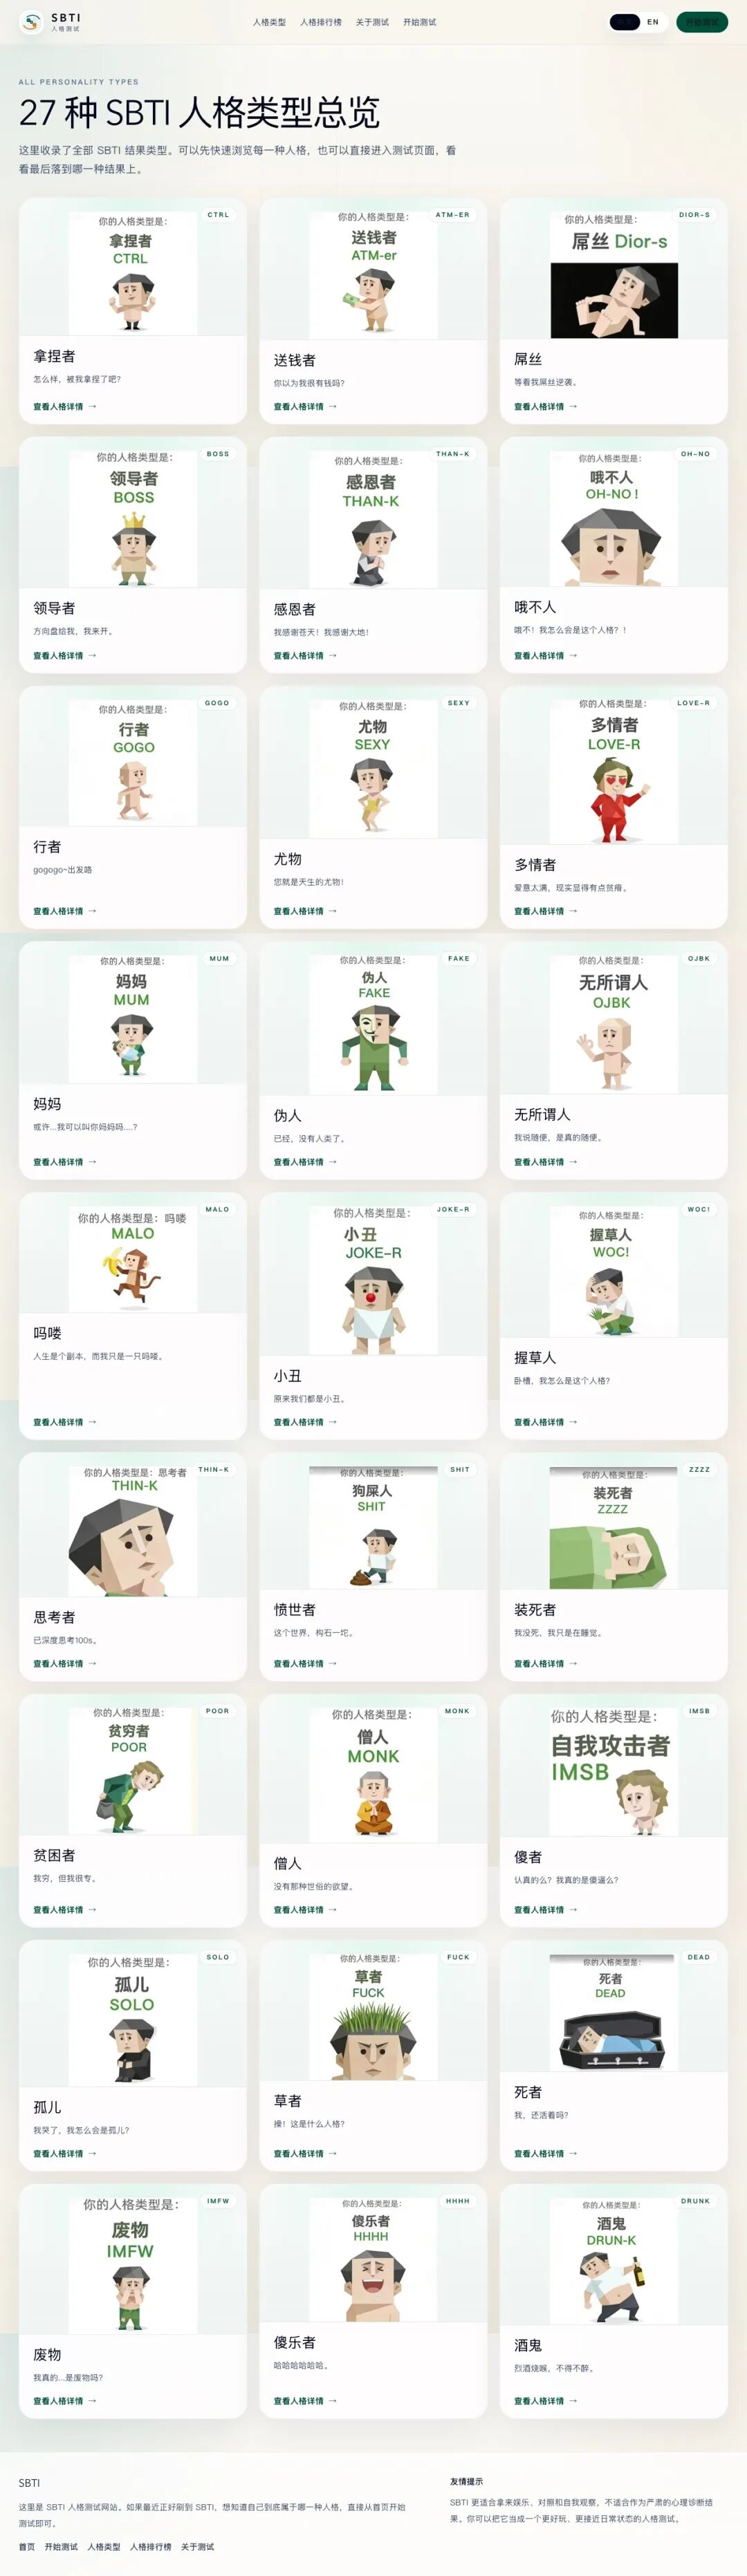
25 种标准人格 + 2 种特殊人格。
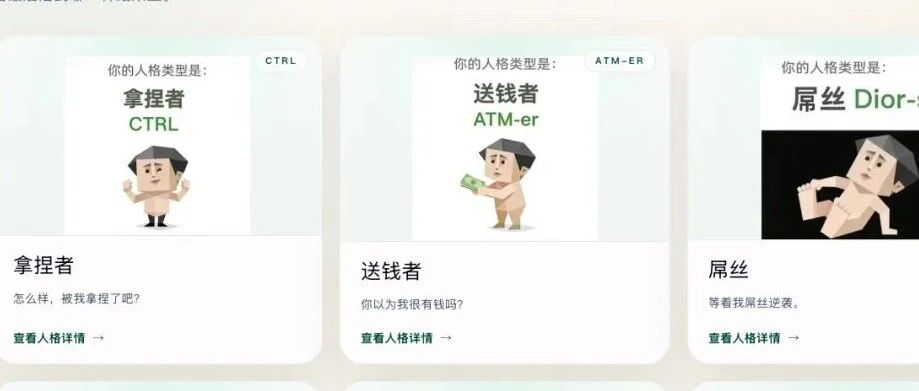
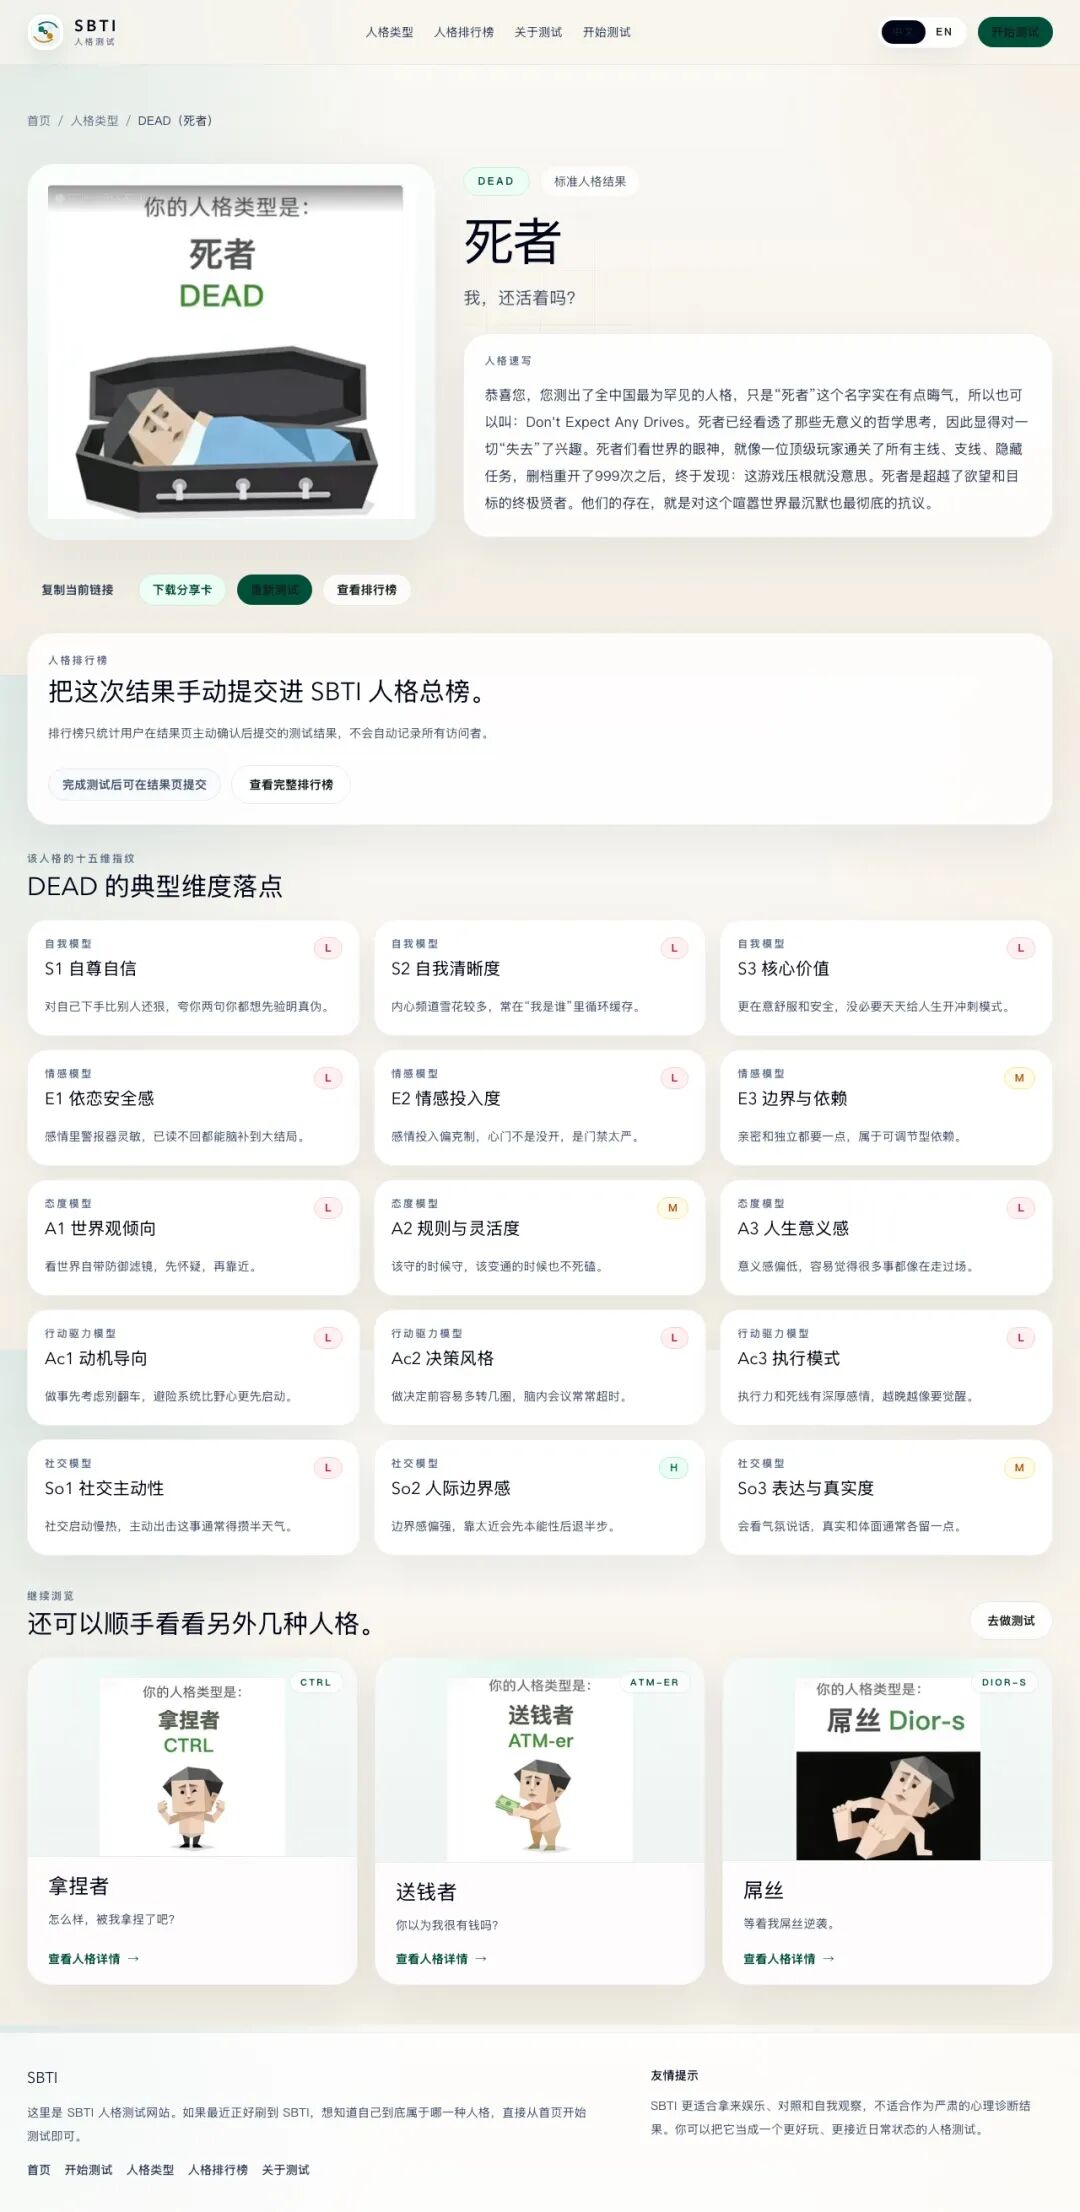
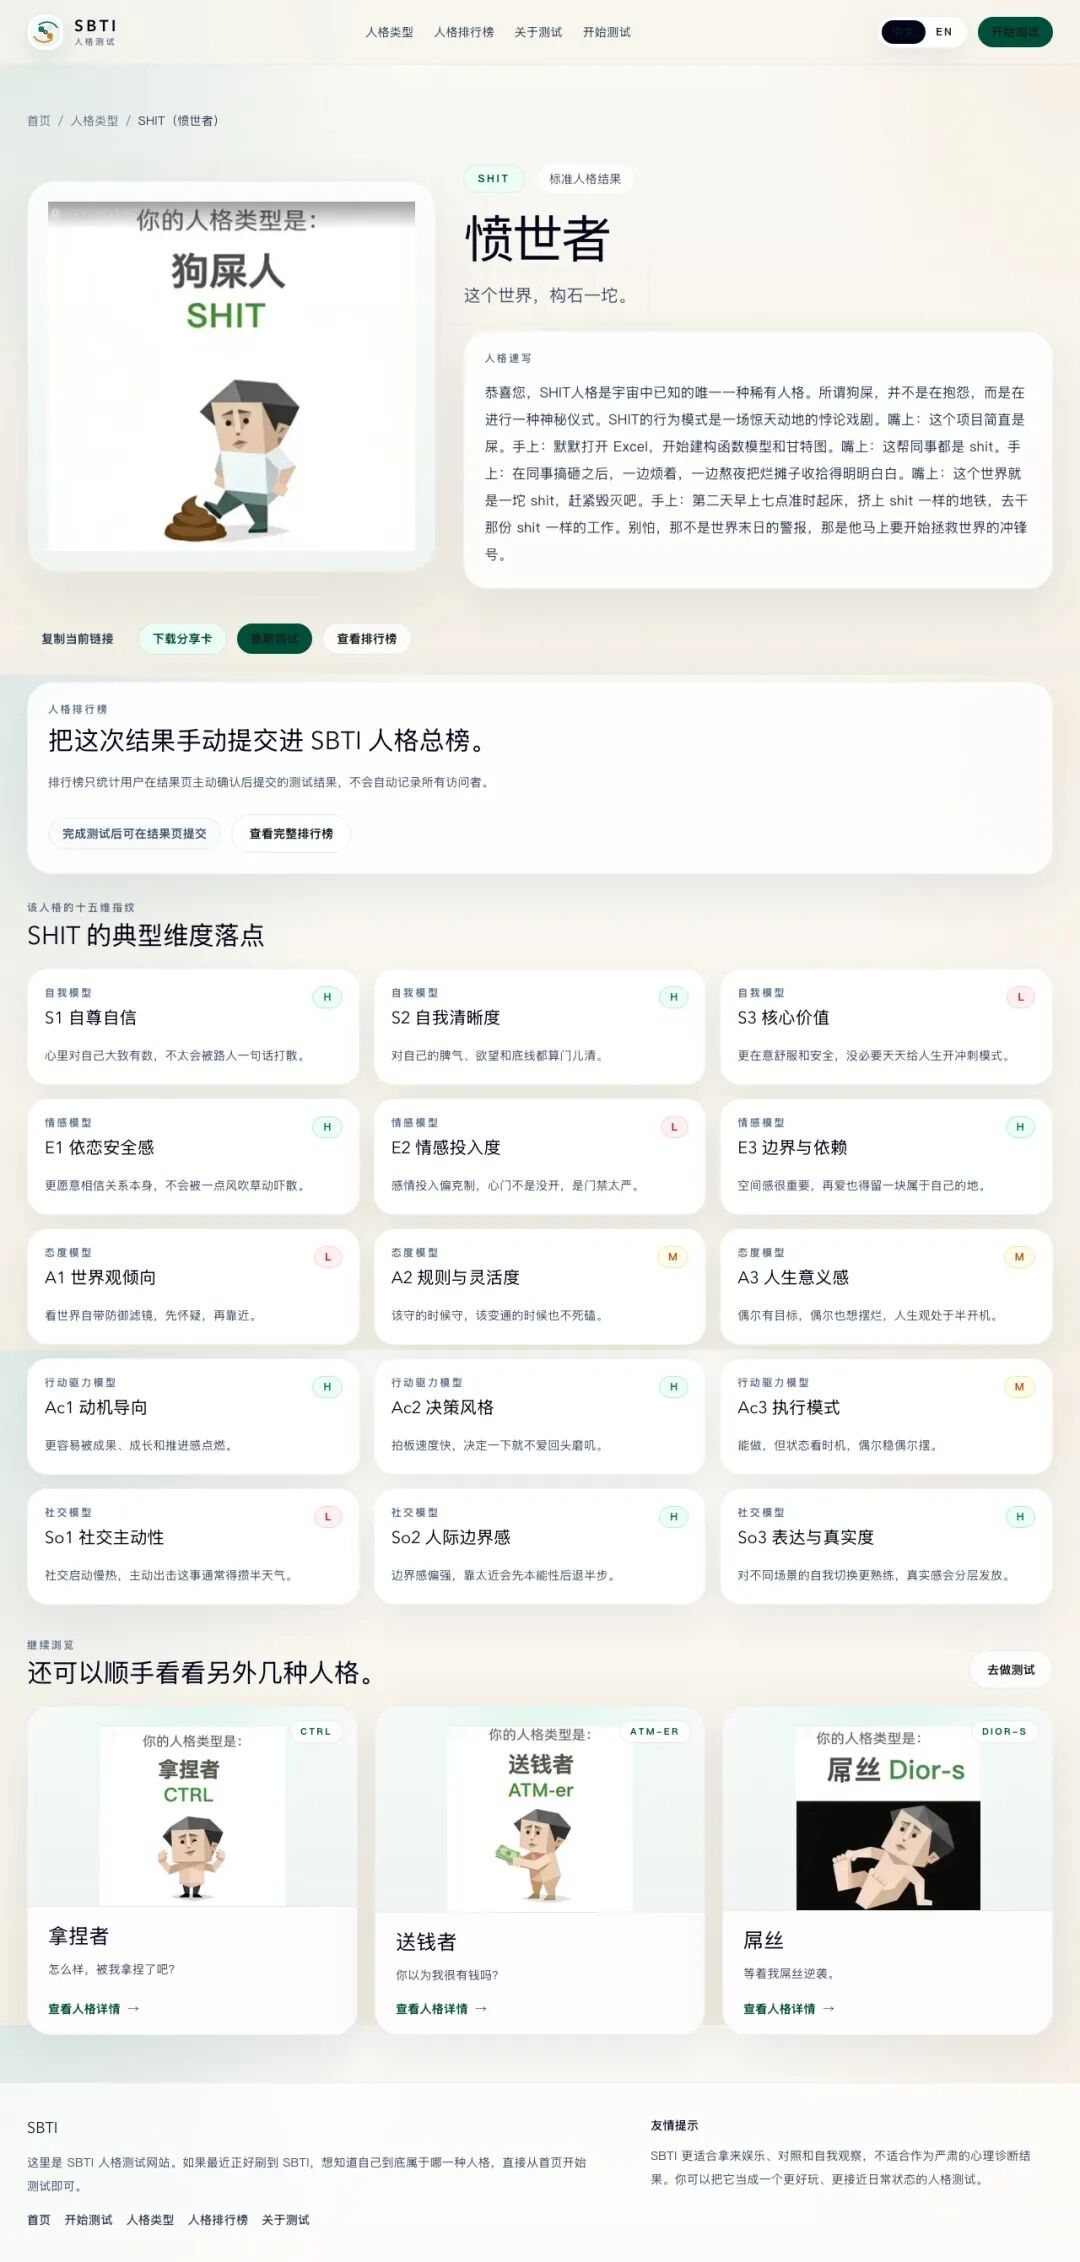
标准人格每一个都很有梗。DEAD(死者)的座右铭是"我,还活着吗?",MALO(吗喽)是"人生是个副本,而我只是一只吗喽",SHIT(愤世者)是"这个世界,构石一坨"。还有 CTRL(拿捏者)、ATM-er(送钱者)、JOKE-R(小丑)、SEXY(尤物)、SOLO(孤儿)、IMSB(傻者)、FUCK(草者)……
两种特殊人格:
DRUNK(酒鬼)——唯一的隐藏触发人格。做题时选了"爱好饮酒",系统会插入一道追加题,如果回答命中条件,直接跳过所有正常匹配,输出酒鬼。这就是 UP 主为朋友量身设计的"陷阱"。
HHHH(傻乐者)——兜底人格。如果你和 25 种标准人格的匹配度都低于 60%,系统会把你归到这里。座右铭是"哈哈哈哈哈哈"。
几个结果页长这样:
顺便提一下排行榜的数据——SEXY(尤物)排第一,9.7%,LOVE-R(多情者)第二,CTRL(拿捏者)第三。大家倾向于提交自己觉得好听的人格,这个行为本身就挺有意思。
实现原理#
这是我最感兴趣的部分。
看到结果页上显示"匹配度 80%""精准命中 10/15 维"的时候,第一反应是:这个匹配度是怎么算的?15 维是哪几维?命中又是啥意思?
其实我最关心的它算的到底准不准。。
扒下源码#
SBTI 的整个实现逻辑,其实都写在前端代码里。
GitHub 上有一个公开的镜像仓库(UnluckyNinja/SBTI-test),里面就一个 index.html,所有算法、题目、人格模板全在里面。
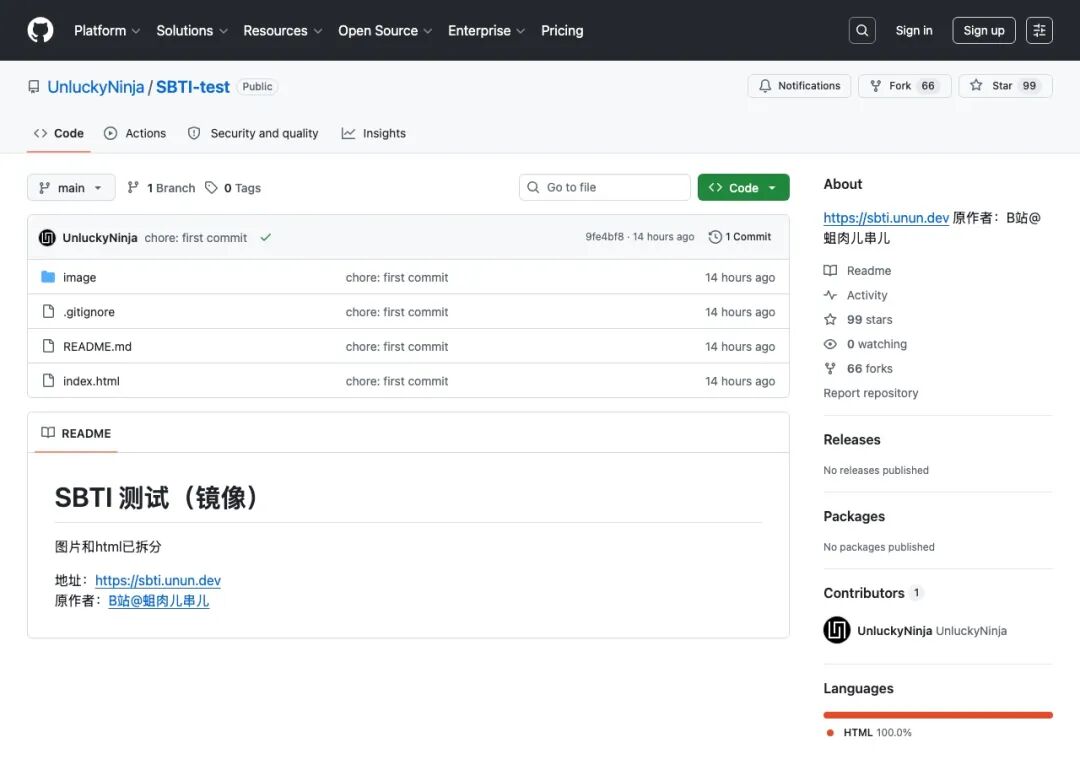
让 Claude 打开这个文件帮我看,发现每种人格后面跟着一串字母,比如:
CTRL   = HHH-HMH-MHH-HHH-MHM
DEAD   = LLL-LLM-LML-LLL-LHM
LOVE-R = MLH-LHL-HLH-MLM-MLH
这就是每种人格的"15 维指纹"——用 L(低)、M(中)、H(高)三档来描述这个人格在 15 个维度上的典型状态。短横线只是分组用的,去掉后按固定顺序 [S1,S2,S3,E1,E2,E3,A1,A2,A3,Ac1,Ac2,Ac3,So1,So2,So3] 展开。
这意味着什么?这些人格的"中心坐标"不是从用户数据里训练出来的,是作者直接定义好的。
想明白这一点之后,整个算法就清楚了。
完整算法:6 步#
一句话版本:答题 → 15 维累计得分 → L/M/H 离散化 → 生成用户向量 → 与 25 个预设人格原型做距离比较 → 选最近的那个。
展开说:
第 1 步:答题
30 道常规题(每个维度 2 题)+ 1 道饮酒门题 + 1 道饮酒触发题。常规题每题 3 个选项,对应分值 1/2/3。所以你实际做的是 31 或 32 道题。
第 2 步:累计到 15 维
每个维度有 2 道题,把两道题的分值加起来,得到这个维度的原始分。范围是 2-6。
第 3 步:离散化
原始分被压成三档:
- 2-3 分 → L(低)
- 4 分 → M(中)
- 5-6 分 → H(高)
这一步很关键。它意味着整个系统不是在一个连续的高维空间里做精确匹配,而是在一个高度离散的有限状态空间里做模式比较。 每个维度只有 3 种可能,15 个维度组合起来,理论上的状态空间是 3^15 = 14,348,907 种——但实际上只有 27 个预设人格在等着你。
第 4 步:生成用户向量
把 L/M/H 映射成数值 1/2/3,你就得到一个 15 维的数字向量。比如如果你的 15 维等级是 HHH-HMH-MMH-HHH-LHL,对应的数值向量就是 [3,3,3,3,2,3,2,2,3,3,3,3,1,3,1]。
第 5 步:与人格原型比较
每种标准人格也有一个 15 维数值向量(从前面说的 pattern 字符串转换而来)。系统对 25 种人格逐一计算与你的距离:
距离 = |你的S1 - 人格S1| + |你的S2 - 人格S2| + ... + |你的So3 - 人格So3|
就是曼哈顿距离,逐维求绝对差值再累加。
同时统计"精准命中维度数":你和这个人格在多少个维度上的等级完全一致。
相似度百分比的计算也很直接:
相似度 = (1 - 距离/30) × 100%
分母 30 是因为 15 个维度 × 每维最大差值 2 = 30。所以理论最低相似度是 0%,最高 100%。
我测出来 80% 意味着距离是 6,也就是 15 个维度里有 10 个完全命中,其余 5 个各差了 1-2 档。
排序规则:先按距离从小到大,距离相同按命中数从大到小。最终选最近的那个作为你的主类型。
第 6 步:特殊规则覆盖
在正常匹配之后,还有两条规则会覆盖结果:
- 如果饮酒触发题命中 → 直接输出 DRUNK,跳过正常匹配
- 如果最高相似度 < 60% → 直接输出 HHHH(傻乐者)
它不是 K-means#
看到"最近中心匹配"你可能会想到 K-means 聚类。但两者有本质区别:
K-means 的中心点是从用户数据里反复迭代算出来的——初始化 → 分配样本 → 更新中心 → 重复直到收敛。中心点会随着数据变化而变化。
SBTI 的人格中心是写死在代码里的。CTRL 就是 HHH-HMH-MHH-HHH-MHM,DEAD 就是 LLL-LLM-LML-LLL-LHM,上线之后不会因为有更多人来测就改变。
更准确地说,SBTI 的算法更接近最近原型匹配(Nearest Centroid)——每个类由一个预设的原型表示,把新样本分给最近的原型。
所以实现上其实非常轻量。不需要训练集,不需要模型,不需要后端。一个 HTML 文件就跑完了全部逻辑。
所以准确性这个事,坦白说我是存疑的。每个人格原型的 15 维坐标怎么定的?这完全是个黑盒,只有作者知道。从代码结构看,更像是作者先想好了"我要一个叫 DEAD 的人格,它应该什么都低",然后反向填 pattern,而不是先收集了一堆真实用户数据再聚类分析出来的。
至于这些人格描述和文案,2026 年了,大概率有 AI 参与。25 个人格每个都有一段风格统一、梗点密集的描述,还要精确对应 15 个维度,纯手写的工作量不小。但核心创意——DRUNK 这种隐藏触发、每个人格的命名和文化梗(吗喽、屌丝、OJBK)——这些是非常"中文互联网原生"的东西,AI 很难凭空想出来。
更可能的情况是:人格设定和维度分配是作者手工设计的,文案和描述用 AI 辅助生成和润色。 这也解释了为什么整体风格这么统一——有一个好的 prompt 模板在后面。
所以 SBTI 测"准不准"?从心理学角度看,它没有任何科学验证。但从体验角度看,15 个维度 × 3 档 × 曼哈顿距离,比 MBTI 的 4 个二元维度分辨率高多了。加上巴纳姆效应(人格描述写得足够模糊和普适,大多数人都会觉得"说的就是我"),体感上确实会觉得有几分准。
25 个人格的完整 pattern#
从代码里可以直接读出所有人格的 15 维指纹:
人格 PatternCTRL 拿捏者 HHH-HMH-MHH-HHH-MHMATM-er 送钱者 HHH-HHM-HHH-HMH-MHLDior-s 屌丝 MHM-MMH-MHM-HMH-LHLBOSS 领导者 HHH-HMH-MMH-HHH-LHLTHAN-K 感恩者 MHM-HMM-HHM-MMH-MHLOH-NO 哦不人 HHL-LMH-LHH-HHM-LHLGOGO 行者 HHM-HMH-MMH-HHH-MHMSEXY 尤物 HMH-HHL-HMM-HMM-HLHLOVE-R 多情者 MLH-LHL-HLH-MLM-MLHMUM 妈妈 MMH-MHL-HMM-LMM-HLLFAKE 伪人 HLM-MML-MLM-MLM-HLHOJBK 无所谓人 MMH-MMM-HML-LMM-MMLMALO 吗喽 MLH-MHM-MLH-MLH-LMHJOKE-R 小丑 LLH-LHL-LML-LLL-MLMWOC! 握草人 HHL-HMH-MMH-HHM-LHHTHIN-K 思考者 HHL-HMH-MLH-MHM-LHHSHIT 愤世者 HHL-HLH-LMM-HHM-LHHZZZZ 装死者 MHL-MLH-LML-MML-LHMPOOR 贫困者 HHL-MLH-LMH-HHH-LHLMONK 僧人 HHL-LLH-LLM-MML-LHMIMSB 傻者 LLM-LMM-LLL-LLL-MLMSOLO 孤儿 LML-LLH-LHL-LML-LHMFUCK 草者 MLL-LHL-LLM-MLL-HLHDEAD 死者 LLL-LLM-LML-LLL-LHMIMFW 废物 LLH-LHL-LML-LLL-MLL
随便挑几个看看:
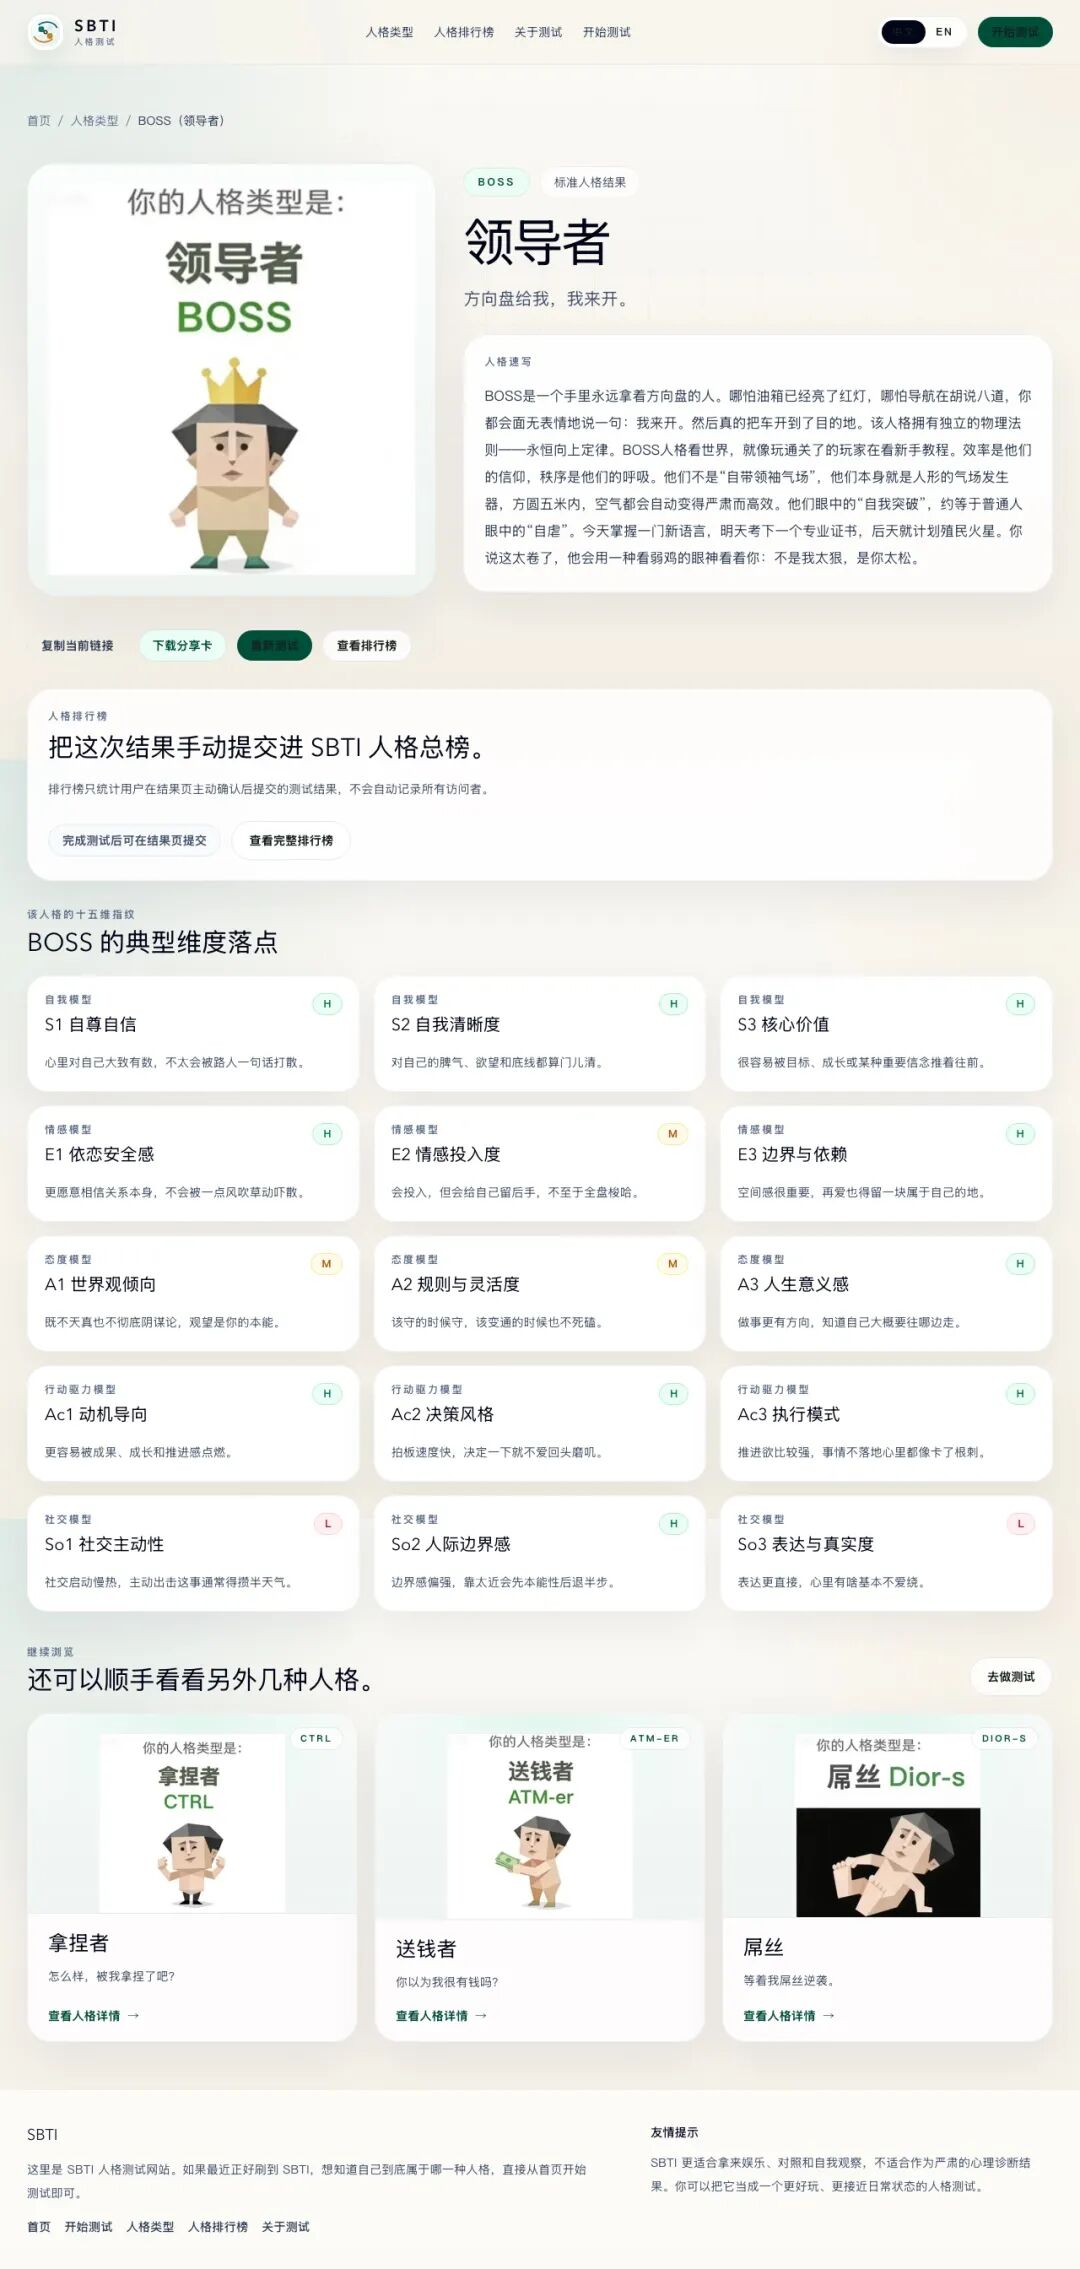
BOSS(领导者):HHH-HMH-MMH-HHH-LHL → [3,3,3,3,2,3,2,2,3,3,3,3,1,3,1]。自我模型全 H、行动驱力全 H,但社交主动性是 L——高自尊、高驱动力、不需要社交认同。”方向盘给我,我来开,但我不需要你夸我”。
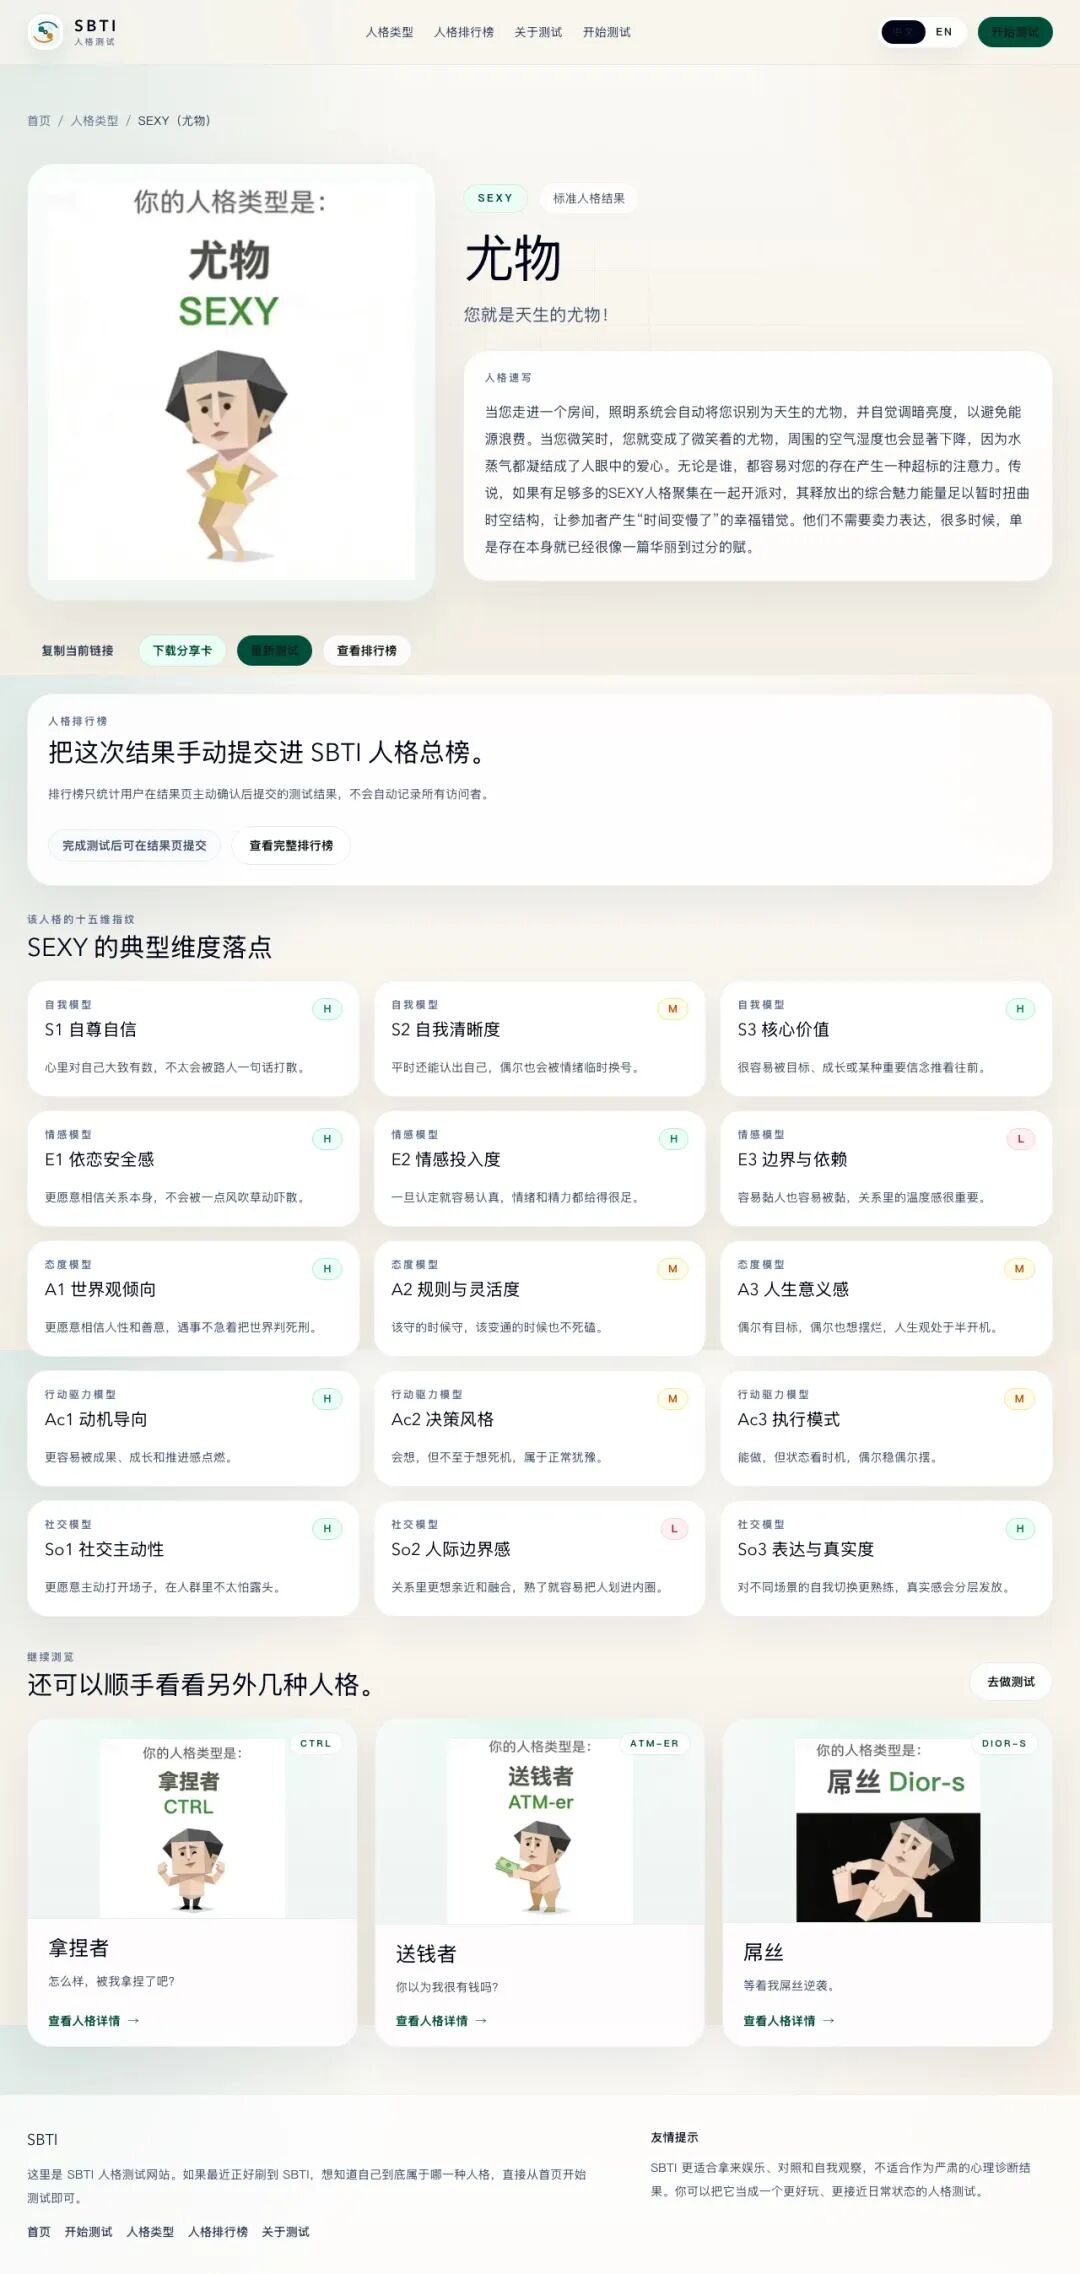
SEXY(尤物):HMH-HHL-HMM-HMM-HLH → [3,2,3,3,3,1,3,2,2,3,2,2,3,1,3]。排行榜第一名,9.7% 的人主动提交了这个结果。自尊高、情感投入高但边界感极低(E3=L)、社交主动性高但人际边界感低——热情、开放、有魅力但容易过度投入。难怪大家愿意晒这个结果。
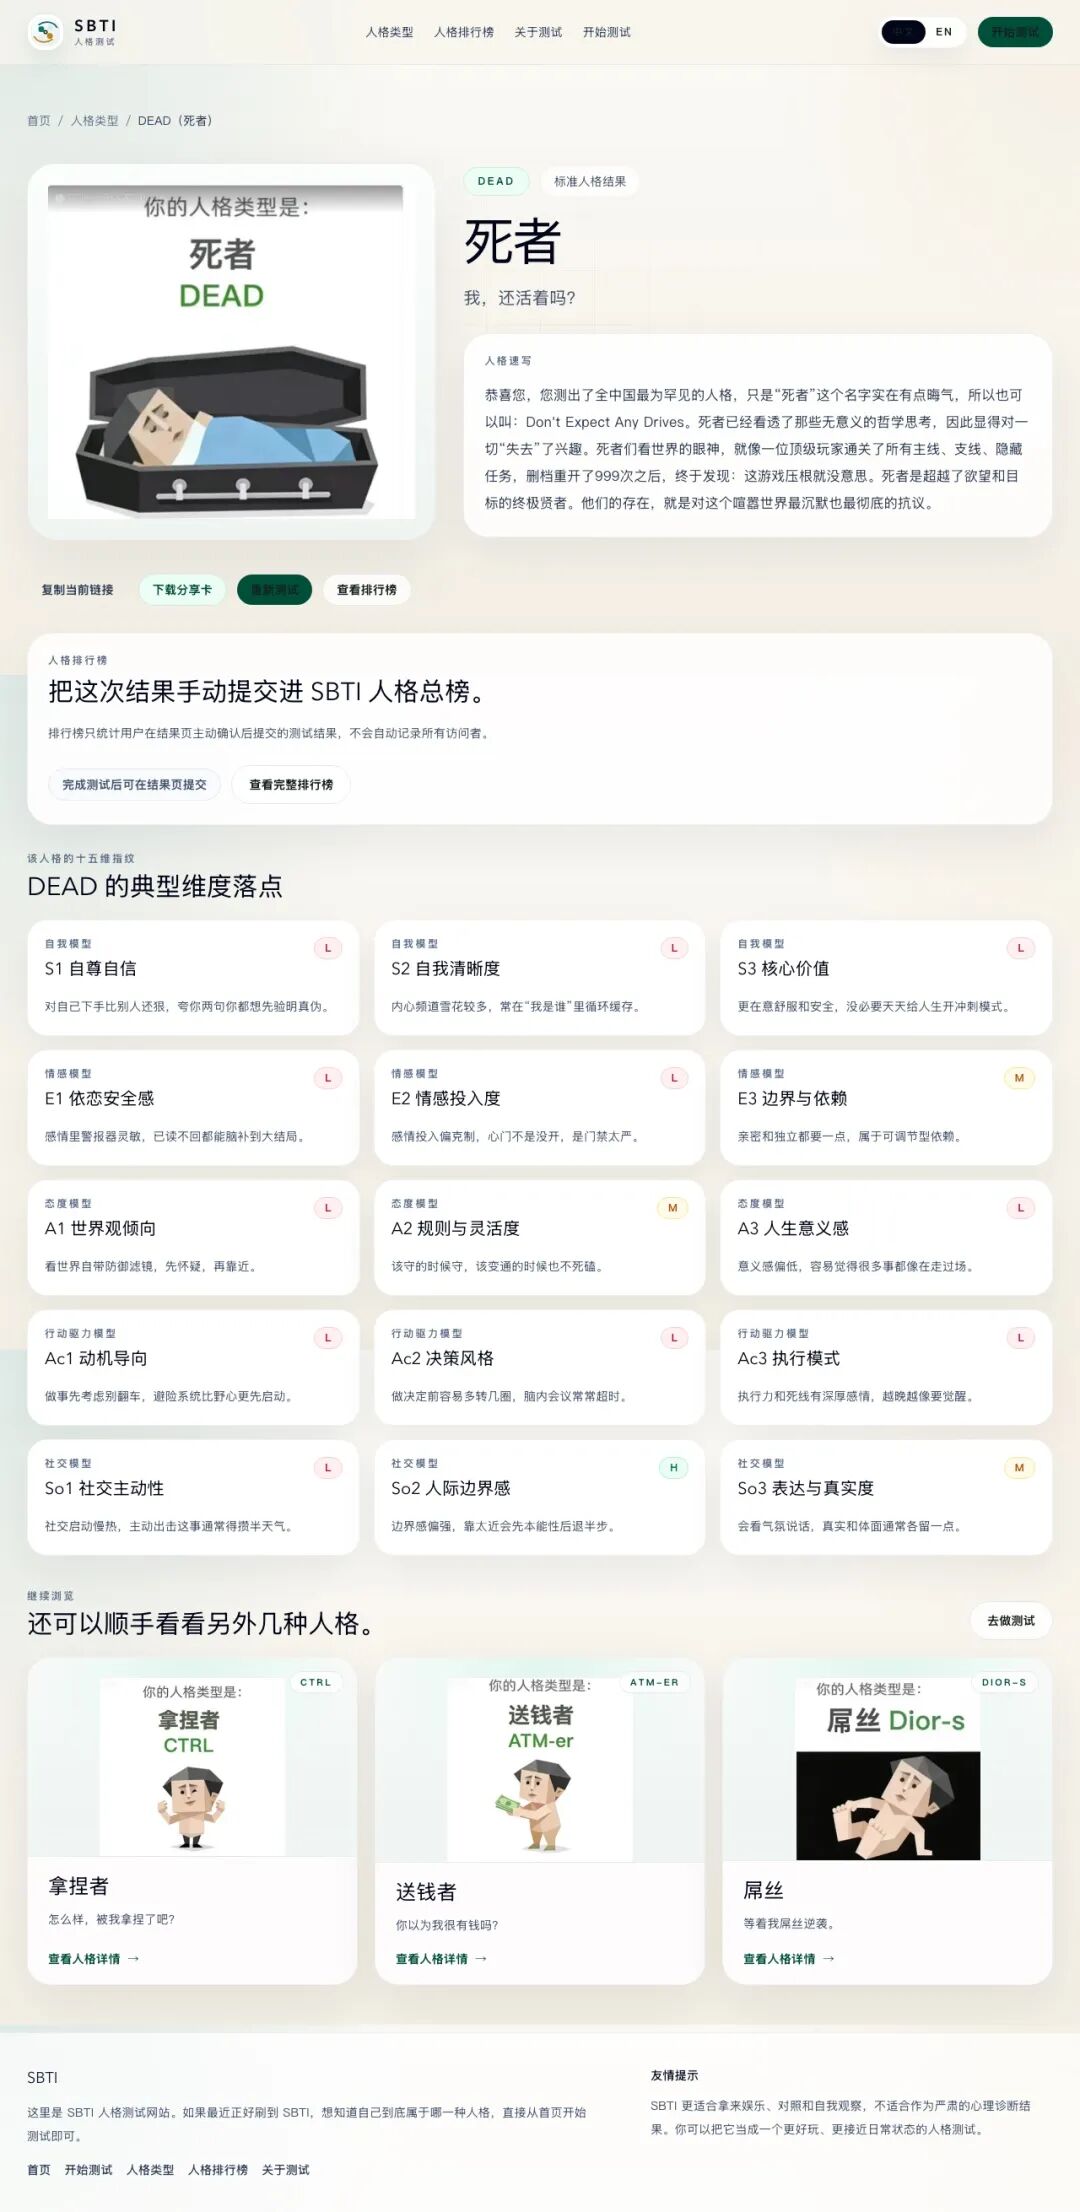
DEAD(死者):LLL-LLM-LML-LLL-LHM → [1,1,1,1,1,2,1,2,1,1,1,1,1,3,2]。15 个维度里 12 个是 L,只有人际边界感是 H——什么都不在乎,但别靠太近。这个 pattern 设计得很精准,”删档重开 999 次的终极贤者”。
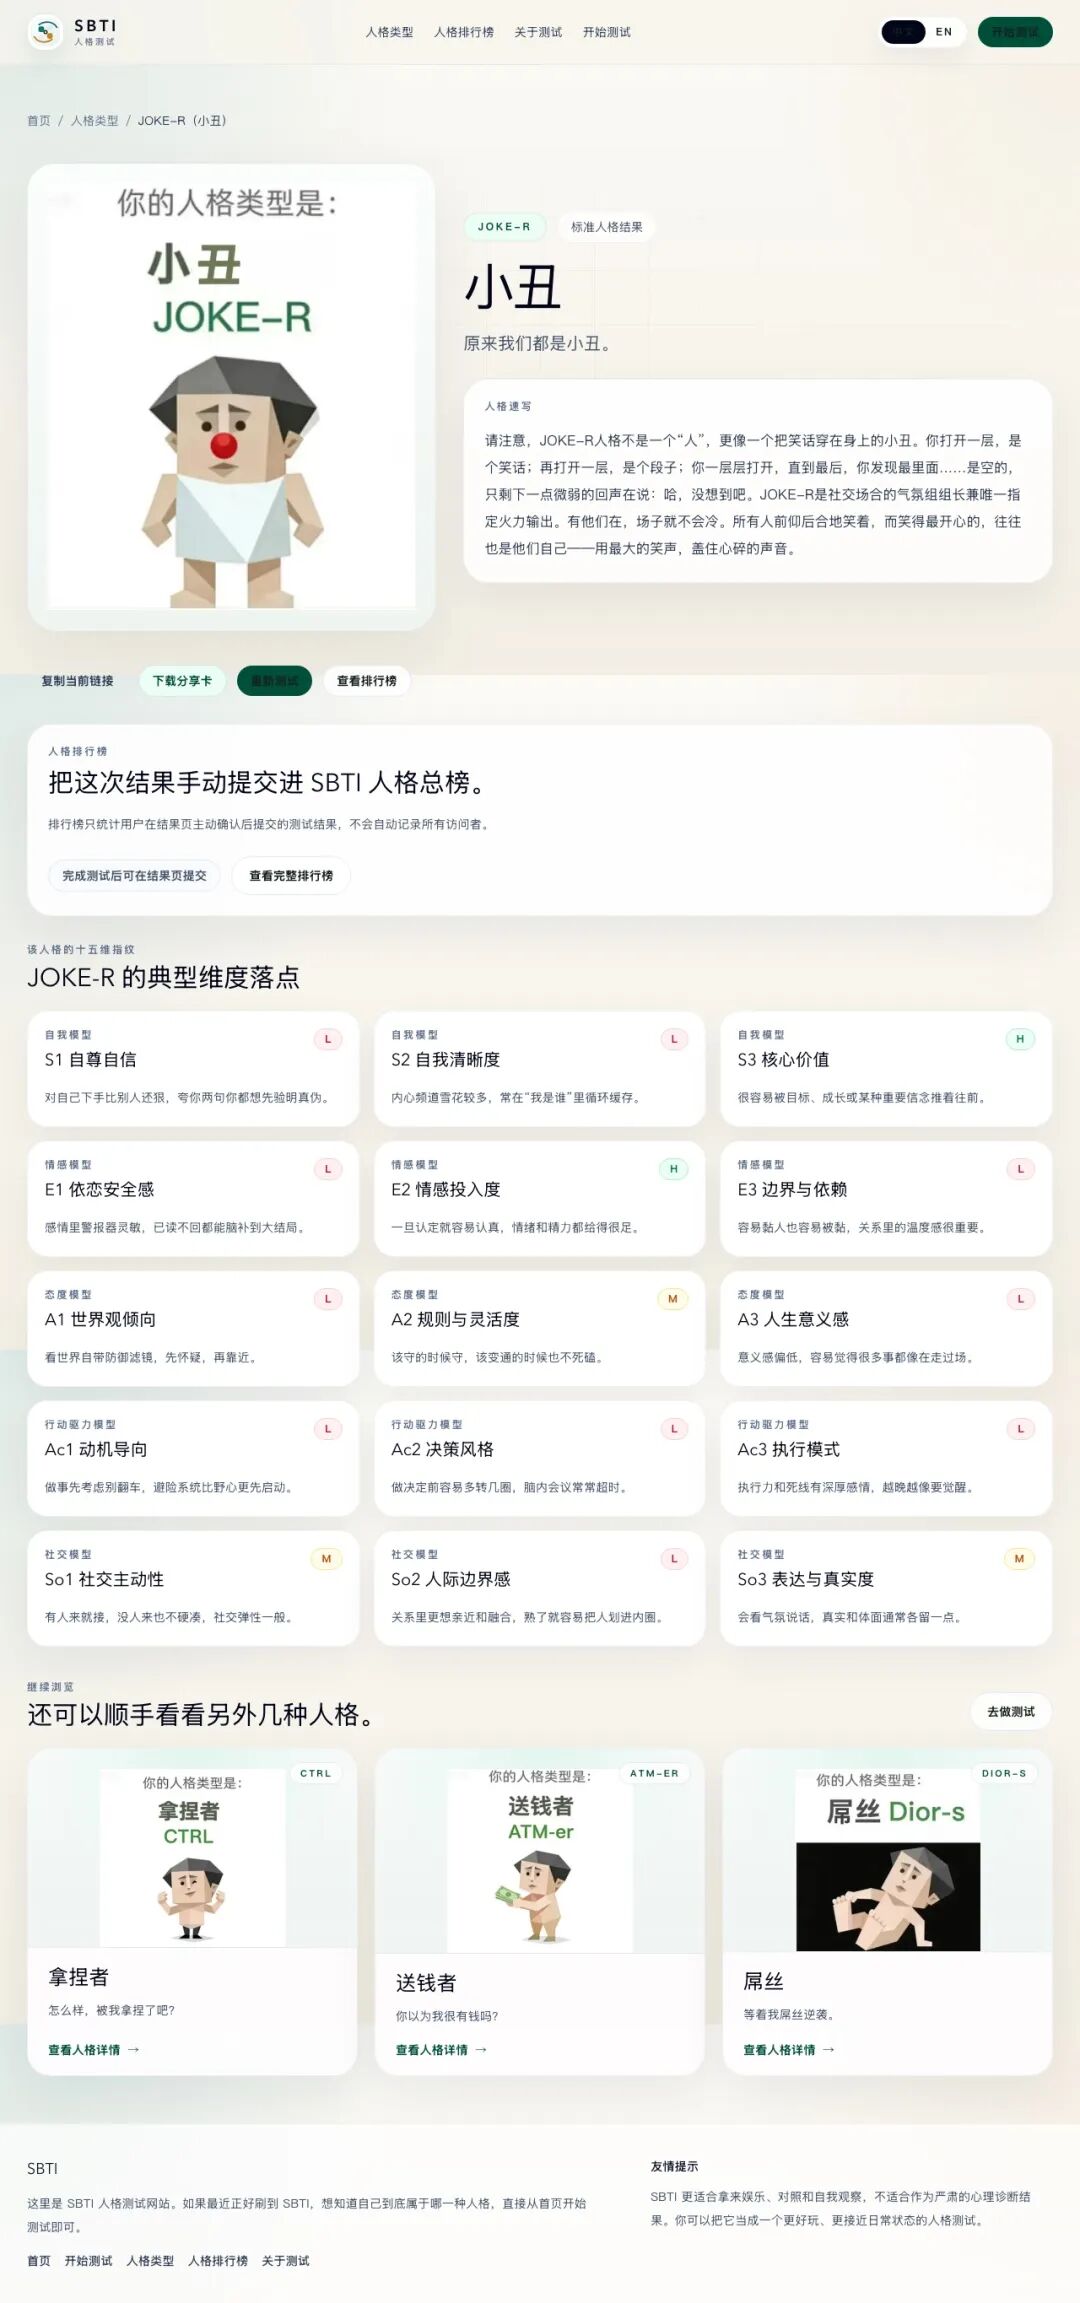
JOKE-R(小丑):LLH-LHL-LML-LLL-MLM → [1,1,3,1,3,1,1,2,1,1,1,1,2,1,2]。自尊自信都是 L,但核心价值是 H、情感投入高——内在有追求,但对自己评价很低。”用最大的笑声盖住心碎的声音”,这个 pattern 和人格描述的对应关系真的很到位。
这张表本身就很有意思。你可以对比两个相似人格的 pattern 差异,看看作者是怎么用 15 个维度把它们区分开的。比如 CTRL(拿捏者)和 BOSS(领导者),差异主要在态度和社交模型上——CTRL 社交更主动(MHM vs LHL),BOSS 更独立。CTRL 是”我拿捏你但我还挺 social 的”,BOSS 是”我来掌舵但你们别来烦我”。
一天怎么就火了#
今早上(4.10)看到这玩意火了,测试完后其实有个疑问,就是为啥能一夜之间传遍整个朋友圈啊,所以看了下原视频和整个时间线。
4 月 9 号中午 11 点,视频发布。一个 6 分半的视频,一个 B 站 UP 主,粉丝量在此之前远没有 12.7 万(这个数字是爆火之后涨的)。
当天下午,网站就崩了。UP 主下午 4 点在评论区说"网站崩了我修复一下"。凌晨 4 点还在发新链接,说"按照建议做了略微修改,相信 b 站技术稳定的力量,应该不会再崩了"。
4 月 9 号当天,微博热搜。
一天,167 万播放,5.4 万转发,2.7 万条评论。
第一个引爆点:故事本身就是好内容#
视频的传播力不是来自"这里有个好玩的测试快来测",而是来自**"一个人为了救朋友做了这么一件事"**。
视频前半段很搞笑。朋友自嘲是废物,吐槽"这简直是胡扯",边做题边喝酒。中间揭晓 DRUNK 人格的时候有惊讶、有尴尬。但到结尾,画风突然变了——结果页列出了酒精危害,朋友沉默了一会儿说"好恐怖啊,我妈是不是找过你",然后是那句"你竟然如此煞费苦心,我明天开始不喝了"。
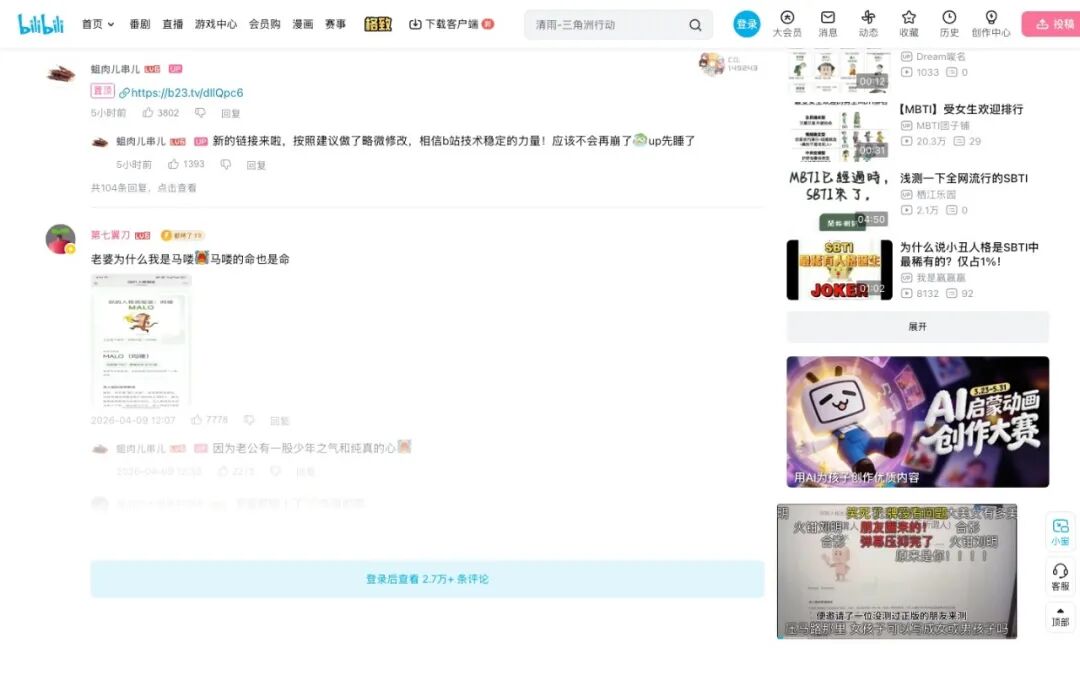
大家分享的不只是一个测试链接,是一个故事。
第二个引爆点:测试本身具备传播基因#
SBTI 的题目不是正经心理测试那种"您在社交场合中更倾向于 A 还是 B",而是"我不够好,周围的人都比我优秀——A.确实 B.有时 C.不是"。
选项直白到有点冒犯,结果标签戏谑到有点自虐。 你拿到的不是"建筑师""调停者"这种体面的标签,是"死者""狗屎人""吗喽"。
但恰恰是这种自嘲感让人愿意晒出来。发一张"我是 INTJ 建筑师"到朋友圈,看起来像在炫耀。发一张"我是 DEAD 死者",看起来像在玩梗。后者的分享门槛低得多。
加上每种人格都有排名,天然形成了比较和讨论的社交闭环——"你是什么?""我是吗喽""哈哈我也是"。
第三个引爆点:服务器崩溃的反向助推#
听起来反直觉,但网站崩了反而加速了传播。打不开 → 截图分享 → 更多人好奇 → 等恢复后涌入 → 又崩。每一轮崩溃都在制造话题。
给我的一些启发#
SBTI 的技术实现并不复杂。一个 HTML 文件,简单的算法,25 个人格模板,没有后端,没有训练集。前面分析过,文案大概率有 AI 辅助,但核心创意和人格设计是人的。放在 2026 年,技术部分谁都能做——算法用 AI 写,人格描述用 AI 润色,前端用 AI 搭,一天之内就能跑起来。
但技术从来不是这件事的壁垒。
壁垒在哪?在于 27 个人格的文案每一条都让人笑出来,在于 DRUNK 这个隐藏人格的巧妙设计,在于"为朋友做了一个测试"这个真实故事,在于 B 站视频里那个从搞笑到温暖的转折。
这些东西不是算法能生成的。
对于所有在做自己产品的人——独立开发者、超级个体、或者就是想做点什么的普通人——SBTI 是一个很好的案例。产品的传播力来自"可玩性"和"可晒性",不来自技术复杂度。 而自媒体,是让我们的东西被看见的渠道。原 up 没有投广告,没有找 KOL,就是发了一条 B 站视频就爆了。
Build in public,永远有效。
最后,我整理了包含 27 种人格的 pattern 模板、算法伪代码、维度对照表, 回复「SBTI」获取完整的 SBTI 实现和解析文档。
相关链接
SBTI 官方原版:sbti.dev
SBTI 国内镜像:sbti.run
B 站原版视频:bilibili.com/video/BV1LpDHByET6
GitHub 镜像仓库:github.com/UnluckyNinja/SBTI-test